1/58
Witajcie na ostatnim wykładzie!
Cel slajdu: Slajd otwiera ostatni wykład i zapowiada warstwy transportową, sesji, prezentacji i aplikacji nad radiowym fundamentem.

Wprowadzenie do warstw wyższych

  • Witam Państwa na naszym finałowym spotkaniu.
  • Przebyliśmy długą drogę, od fizycznych fal radiowych, przez ramki i adresy MAC, aż po globalny routing oparty na adresach IP.
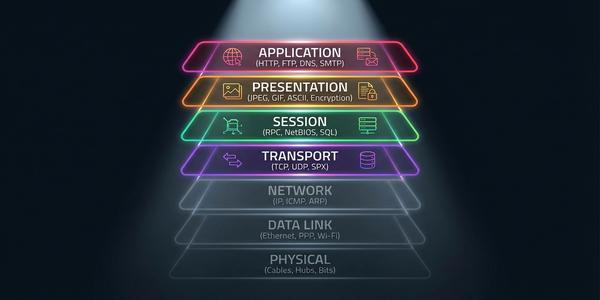
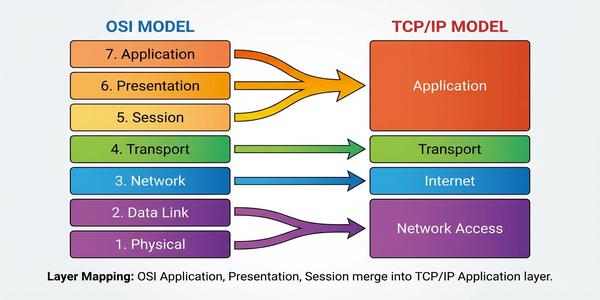
  • Dziś wspinamy się na szczyt modelu OSI, aby omówić warstwy wyższe: Transportową, Sesji, Prezentacji i Aplikacji.
  • To właśnie te warstwy przekształcają surową komunikację sieciową w użyteczne i niezawodne usługi, z których korzystamy na co dzień.
  • Zobaczymy, jak zapewniana jest niezawodność transmisji, jak zarządzane są dialogi między aplikacjami i wreszcie, jak protokoły takie jak HTTP czy DNS umożliwiają nam przeglądanie stron internetowych przez naszą sieć Wi-Fi.
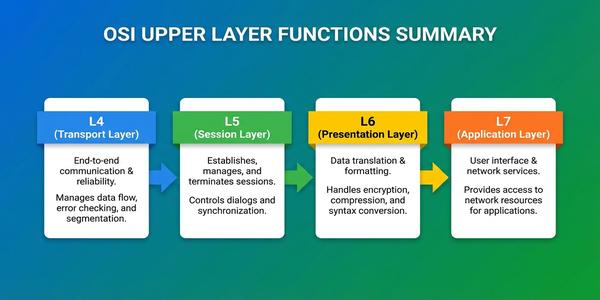
Wyższe warstwy modelu OSI (warstwy 4-7): Warstwa transportowa zapewnia niezawodność między aplikacjami, warstwa sesji zarządza dialogami, warstwa prezentacji formatuje i szyfruje dane, a warstwa aplikacji dostarcza protokoły pokroju HTTP i DNS. Niestabilność radia WLAN przenosi się w górę jako retransmisje i opóźnienia, dlatego protokoły wyższe muszą być odporne na chwilowe zaniki. Zrozumienie całego stosu zamyka drogę od fali radiowej do usługi.
Wprowadzenie do Warstw Wyższych

Podczas poprzednich czterech części cyklu prześledziliśmy drogę danych od fal radiowych aż po adresację globalną. Dzisiejszy wykład stanowi zwieńczenie tej podróży i koncentruje się na mechanizmach, które sprawiają, że komunikacja sieciowa jest niezawodna, bezpieczna i dostosowana do potrzeb konkretnych aplikacji. Warstwy wyższe modelu OSI, od transportowej aż po aplikacyjną, są tym fragmentem stosu protokołów, z którym użytkownik końcowy ma styczność pośrednio lub bezpośrednio każdego dnia, nawet jeśli nie zdaje sobie z tego sprawy. Zrozumienie ich działania jest kluczowe dla każdego inżyniera sieciowego, ponieważ to właśnie na tych warstwach zapadają decyzje o retransmisji, priorytetyzacji ruchu i szyfrowaniu danych. W kontekście sieci WLAN wyzwaniem staje się fakt, że niestabilność łącza radiowego na warstwach niższych może istotnie wpływać na działanie protokołów wyższych warstw.

W trakcie tego wykładu omówione zostaną konkretne protokoły i mechanizmy działające na warstwach od czwartej do siódmej, z uwzględnieniem specyfiki środowisk bezprzewodowych. Szczególna uwaga poświęcona zostanie problemom wynikającym z opóźnień i utraty pakietów w łączu radiowym, które mogą zaburzać mechanizmy kontroli zatłoczenia w protokole TCP. Przeanalizujemy również, w jaki sposób nowoczesne protokoły, takie jak QUIC, próbują rozwiązać te problemy, oferując lepszą wydajność w sieciach WLAN niż tradycyjne rozwiązania.

2/58
Warstwa 4: Warstwa Transportowa
Cel slajdu: Slajd wprowadza warstwę transportową jako komunikację między procesami z wyborem niezawodności albo szybkości.

Strażnik niezawodności i porządku

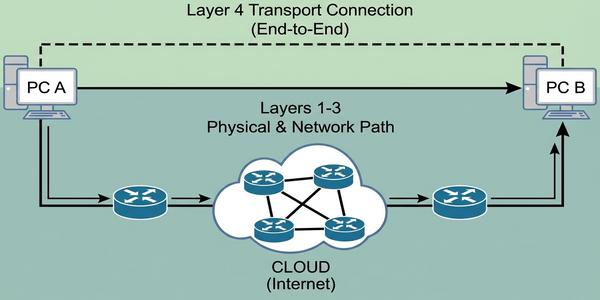
  • Warstwa transportowa jest sercem komunikacji "od końca do końca" (end-to-end).
  • Podczas gdy warstwy niższe zajmowały się przesyłaniem danych między sąsiednimi urządzeniami, warstwa 4 odpowiada za komunikację między konkretnymi aplikacjami na komputerze źródłowym i docelowym.
  • Jej głównym zadaniem jest zapewnienie niezawodnego dostarczania danych, kontrolowanie przepływu, aby szybszy nadawca nie "zalał" wolniejszego odbiorcy, a także dzielenie dużych porcji danych na mniejsze segmenty i składanie ich z powrotem w odpowiedniej kolejności.
  • To ona decyduje, czy komunikacja ma być szybka i zawodna, czy wolniejsza, ale w 100% gwarantowana.
Warstwa transportowa, warstwa 4 (ang. transport layer): Warstwa zapewnia komunikację między aplikacjami końcowymi poprzez segmentację, kontrolę przepływu i wybór między niezawodnym TCP a szybkim UDP. Porty identyfikują procesy na hoście, a nie same urządzenia. W WLAN zmienne opóźnienia i zrywanie łączności wystawiają mechanizmy transportowe na ciężką próbę.
Warstwa 4: Warstwa Transportowa

Warstwa transportowa pełni funkcję pośrednika między procesami aplikacyjnymi a infrastrukturą sieciową, umożliwiając komunikację typu koniec-koniec między hostami. W odróżnieniu od warstwy sieciowej, która zajmuje się dostarczaniem pakietów między urządzeniami, warstwa transportowa koncentruje się na dostarczaniu danych do konkretnych aplikacji działających na tych urządzeniach. Realizuje to za pomocą mechanizmu portów, które jednoznacznie identyfikują proces oczekujący na dane w systemie operacyjnym. W sieciach WLAN warstwa transportowa musi radzić sobie z dodatkowymi wyzwaniami, takimi jak zwiększona zmienność opóźnień i okresowe zrywanie łączności radiowej, które mogą prowadzić do niepotrzebnych retransmisji.

Każdy segment warstwy transportowej zawiera nagłówek z numerami portów źródłowego i docelowego, dzięki czemu system operacyjny może przekazać odebrane dane do właściwego procesu. Warstwa transportowa może również zapewniać dodatkowe usługi, takie jak kontrola poprawności danych za pomocą sum kontrolnych, multipleksowanie wielu połączeń między tymi samymi parami hostów oraz zarządzanie przepływem danych. Protokoły transportowe są implementowane w jądrze systemu operacyjnego, co zapewnia im wysoki priorytet wykonywania i dostęp do zasobów sprzętowych.

3/58
Porty: Drzwi do aplikacji
Cel slajdu: Slajd wyjaśnia 16-bitowe numery portów jako drzwi kierujące ruch do właściwych aplikacji.

Jak dane trafiają do właściwego programu?

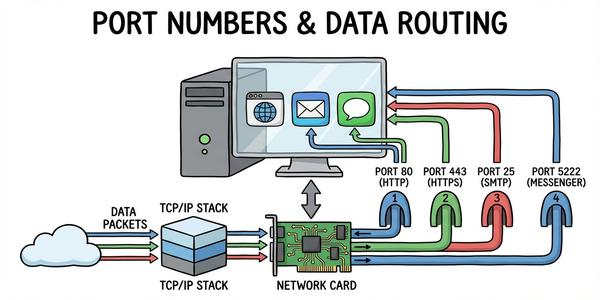
  • Na jednym komputerze może działać jednocześnie wiele aplikacji korzystających z sieci: przeglądarka, klient poczty, komunikator.
  • Jak system operacyjny wie, które dane są przeznaczone dla której aplikacji?
  • Służą do tego numery portów.
  • Port to 16-bitowa liczba (od 0 do 65535) działająca jak numer "drzwi" lub "okienka" dla konkretnej usługi.
  • Każde połączenie sieciowe jest jednoznacznie identyfikowane przez parę: adres IP i numer portu.
  • Na przykład, gdy łączymy się ze stroną WWW, nasza przeglądarka wysyła dane na adres IP serwera i standardowy port 80 (dla HTTP) lub 443 (dla HTTPS).
Port (ang. port number): Szesnastobitowy numer portu od 0 do 65535 identyfikuje aplikację: zakres znany do 1023 obejmuje usługi pokroju HTTP 80 i HTTPS 443, zakres rejestrowany do 49151 popularne aplikacje, a zakres dynamiczny powyżej służy stronom inicjującym. Para adres IP plus port jednoznacznie wskazuje proces. Zapory i kontrolery WLAN filtrują ruch właśnie na podstawie portów.
Porty: Drzwi do Aplikacji

Numery portów są szesnastobitowymi liczbami całkowitymi, co oznacza, że mogą przyjmować wartości od zera do sześćdziesięciu pięciu tysięcy pięciuset trzydziestu pięciu. Zakres ten został podzielony na trzy kategorie: porty dobrze znane od zera do tysiąca dwudziestu trzech, zarezerwowane dla standardowych usług i protokołów, porty zarejestrowane od tysiąca dwudziestu czterech do czterdziestu dziewięciu tysięcy stu pięćdziesięciu jeden, przeznaczone dla aplikacji producenckich, oraz porty dynamiczne i prywatne od czterdziestu dziewięciu tysięcy stu pięćdziesięciu dwóch do sześćdziesięciu pięciu tysięcy pięciuset trzydziestu pięciu, używane tymczasowo przez klientów. Gdy aplikacja kliencka inicjuje połączenie, system operacyjny przydziela jej tymczasowy port źródłowy z zakresu dynamicznego, który jest zwalniany po zakończeniu komunikacji.

W sieciach WLAN znajomość numerów portów jest niezbędna przy konfiguracji zapór ogniowych i list kontroli dostępu na punktach dostępowych oraz kontrolerach WLAN. Blokowanie lub ograniczanie dostępu do określonych portów pozwala na precyzyjną kontrolę ruchu sieciowego i zwiększenie bezpieczeństwa infrastruktury bezprzewodowej. Jednocześnie niektóre protokoły, takie jak FTP w trybie aktywnym, wykorzystują dodatkowe, dynamicznie negocjowane porty do transmisji danych, co może komplikować konfigurację zabezpieczeń.

4/58
Gniazdo (Socket)
Cel slajdu: Slajd definiuje gniazdo jako parę adresu i portu oraz połączenie jako parę gniazd.

Punkt końcowy komunikacji

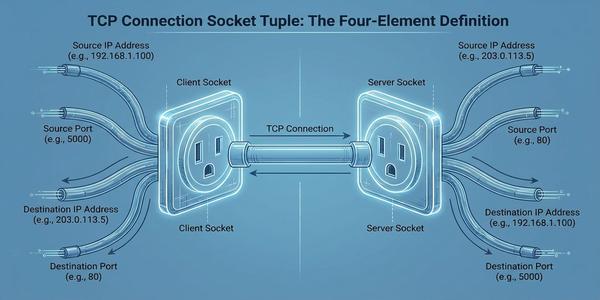
  • Połączenie adresu IP z numerem portu tworzy unikalny punkt końcowy komunikacji, zwany gniazdem (socket).
  • Pełne połączenie sieciowe jest definiowane przez parę gniazd: gniazdo na komputerze źródłowym i gniazdo na komputerze docelowym.
  • Na przykład, gdy przeglądarka na Twoim laptopie łączy się z serwerem Google, pełna specyfikacja połączenia może wyglądać tak:
  • Gniazdo źródłowe: `192.168.1.10:51234` (Twój IP : losowy port)
  • Gniazdo docelowe: `142.250.203.196:443` (IP Google : port HTTPS)
  • To właśnie dzięki unikalności tej kombinacji Twój router i komputer potrafią zarządzać wieloma jednoczesnymi połączeniami z różnych aplikacji i kart przeglądarki.
Gniazdo, socket (ang. socket): Gniazdo to połączenie adresu IP z numerem portu, na przykład 192.168.1.10:51234, a pełne połączenie opisuje piątka: protokół, adresy i porty obu końcówek. W systemie operacyjnym gniazdo jest deskryptorem pliku obsługiwanym wywołaniami systemowymi. Roaming zmieniający adres IP zrywa gniazdo, czemu zapobiegają mechanizmy szybkiego roamingu i mobilności IP.
Gniazdo (Socket)

Gniazdo sieciowe, określane w języku angielskim mianem socket, stanowi abstrakcję programistyczną reprezentującą jeden punkt końcowy dwukierunkowej ścieżki komunikacyjnej między procesami działającymi na różnych hostach. W systemach uniksowych i linuksowych gniazdo jest implementowane jako deskryptor pliku, co oznacza, że operacje na gnieździe można wykonywać za pomocą tych samych funkcji systemowych, co operacje na zwykłych plikach. Każde gniazdo jest jednoznacznie identyfikowane przez pięć parametrów: protokół transportowy, adres IP źródła, port źródłowy, adres IP miejsca docelowego oraz port docelowy. Ta pięcioelementowa krotka gwarantuje, że w ramach jednego systemu operacyjnego może istnieć wiele jednoczesnych połączeń obsługiwanych przez tę samą aplikację.

W praktyce sieci WLAN, gdzie urządzenia klienckie często zmieniają punkty dostępowe podczas roamingu, utrzymanie spójności gniazd sieciowych jest wyzwaniem technicznym. Aplikacje wrażliwe na zmianę adresu IP, takie jak wideokonferencje czy gry online, mogą doświadczać przerw w komunikacji podczas przełączania między punktami dostępowymi. Protokół Mobile IP oraz nowoczesne rozwiązania w standardzie 802.11r i 802.11k mają na celu zminimalizowanie tych przerw poprzez szybsze ponowne ustanawianie połączeń i zachowanie ciągłości sesji.

5/58
Dwa protokoły: TCP i UDP
Cel slajdu: Slajd zestawia niezawodny, połączeniowy TCP z szybkim, bezpołączeniowym UDP.

Niezawodność kontra szybkość

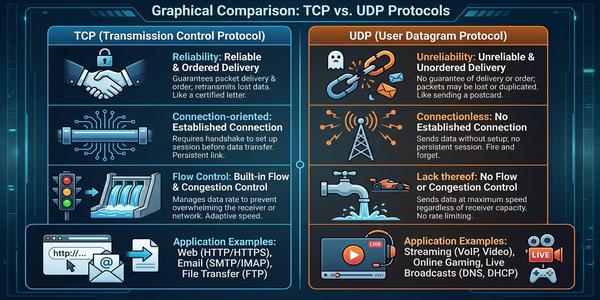
  • Warstwa transportowa oferuje dwa główne protokoły, które realizują zupełnie różne filozofie komunikacji.
  • TCP (Transmission Control Protocol): Protokół zorientowany na połączenie, niezawodny i uporządkowany. Gwarantuje, że wszystkie dane dotrą do celu w całości i w odpowiedniej kolejności. Jest jak list polecony z potwierdzeniem odbioru.
  • UDP (User Datagram Protocol): Protokół bezpołączeniowy, prosty, szybki i zawodny. Wysyła dane i "nie ogląda się za siebie". Nie ma żadnej gwarancji dostarczenia ani zachowania kolejności. Jest jak zwykła kartka pocztowa.
  • Wybór między TCP a UDP zależy wyłącznie od wymagań aplikacji.
Protokoły TCP i UDP (RFC 793, RFC 768): Protokół TCP jest połączeniowy, numeruje bajty, potwierdza odbiór i retransmituje braki, jak list polecony za potwierdzeniem. Protokół UDP wysyła samodzielne datagramy bez nawiązania połączenia i gwarancji, jak kartkę pocztową, przy minimalnym 8-bajtowym nagłówku wobec co najmniej 20 bajtów TCP. Wybór zależy od tego, czy aplikacja ceni integralność, czy minimalne opóźnienie, a WLAN uwypukla tę różnicę.
Dwa Protokoły: TCP i UDP

Wybór między protokołem TCP a UDP ma fundamentalne znaczenie dla charakteru komunikacji sieciowej i powinien być podyktowany wymaganiami konkretnej aplikacji. TCP, dzięki mechanizmom potwierdzeń, retransmisji i porządkowania segmentów, gwarantuje niezawodne dostarczenie danych kosztem zwiększonego narzutu protokołowego i wyższych opóźnień. UDP natomiast, rezygnując z tych mechanizmów, oferuje minimalny narzut i małe opóźnienia, co czyni go idealnym dla aplikacji czasu rzeczywistego, w których pojedyncze utracone pakiety są akceptowalne. W sieciach WLAN różnica między tymi protokołami staje się szczególnie widoczna, ponieważ zawodność łącza radiowego może prowadzić do częstych retransmisji TCP, obniżających jego efektywną przepustowość.

Nagłówek TCP ma długość co najmniej dwudziestu bajtów i zawiera pola niezbędne do realizacji niezawodnej transmisji, takie jak numery sekwencyjne, numery potwierdzeń oraz pole rozmiaru okna. Nagłówek UDP ma natomiast zaledwie osiem bajtów, co przy niewielkich pakietach używanych przez DNS czy DHCP stanowi znaczną oszczędność w stosunku do całkowitego rozmiaru ramki. Współczesne aplikacje często łączą zalety obu protokołów, na przykład używając TCP do sterowania i sygnalizacji, a UDP do transmisji danych multimedialnych.

6/58
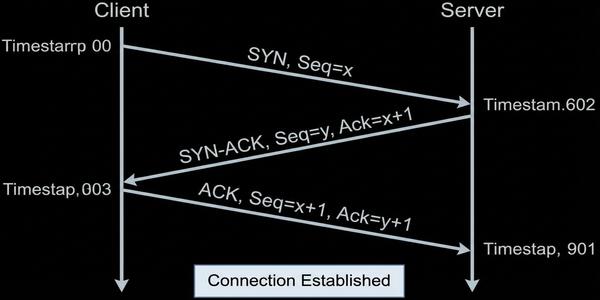
TCP: Nawiązywanie połączenia (3-Way Handshake)
Cel slajdu: Slajd opisuje trójstopniowe nawiązanie połączenia TCP z uzgodnieniem numerów sekwencyjnych.

"Czy mnie słyszysz? Tak, słyszę. OK, zaczynamy."

  • Zanim TCP zacznie przesyłać jakiekolwiek dane, musi najpierw ustanowić formalne połączenie między klientem a serwerem.
  • Służy do tego proces zwany trójetapowym uzgadnianiem (3-Way Handshake).
    1. SYN: Klient wysyła do serwera segment z ustawioną flagą SYN (Synchronize), inicjując połączenie i proponując swój numer sekwencyjny.
    2. SYN-ACK: Serwer, jeśli jest gotowy, odpowiada segmentem z flagami SYN i ACK (Acknowledgement). Potwierdza w ten sposób otrzymanie prośby klienta i również proponuje swój numer sekwencyjny.
    3. ACK: Klient odsyła ostatni segment, z ustawioną flagą ACK, potwierdzając otrzymanie odpowiedzi serwera.
  • Po tej wymianie połączenie jest ustanowione i obie strony są gotowe do wymiany danych.
Nawiązanie połączenia TCP, three-way handshake: Klient wysyła flagę SYN z losowym początkowym numerem sekwencyjnym ISN, serwer odpowiada SYN-ACK z własnym numerem, a klient potwierdza ACK, po czym połączenie przechodzi w stan ESTABLISHED. Strony uzgadniają też maksymalny rozmiar segmentu MSS i skalę okna. W WLAN rywalizacja o eter w CSMA/CA wydłuża tę wymianę, a zamykanie wymaga osobnej, czteroetapowej wymiany flag FIN i ACK.
TCP: Nawiązywanie Połączenia (3-Way Handshake)

Trójetapowe uzgadnianie pełni funkcję inicjalizacji połączenia TCP, podczas której obie strony uzgadniają początkowe numery sekwencyjne oraz negocjują opcjonalne parametry połączenia, takie jak maksymalny rozmiar segmentu czy skala okna. Proces ten jest niezbędny do zapewnienia niezawodności transmisji, ponieważ pozwala obu stronom na potwierdzenie wzajemnej gotowości do komunikacji. W sieciach WLAN trójetapowe uzgadnianie jest szczególnie narażone na opóźnienia związane z dostępem do medium, ponieważ przed wysłaniem segmentów TCP urządzenie klienckie musi przejść przez procedurę CSMA/CA, co wydłuża cały proces nawiązywania połączenia.

Numery sekwencyjne wymieniane podczas uzgadniania są losowo wybierane przez każdą ze stron, co zapobiega atakom polegającym na wstrzykiwaniu fałszywych segmentów do istniejącego połączenia. Po pomyślnym zakończeniu trójetapowego uzgadniania, obie strony ustawiają w swoich strukturach danych stan ESTABLISHED i rozpoczynają właściwą wymianę danych. Zakończenie połączenia TCP wymaga oddzielnej, czteroetapowej sekwencji z wykorzystaniem flag FIN i ACK, która zapewnia uporządkowane zamknięcie obu kierunków transmisji.

7/58
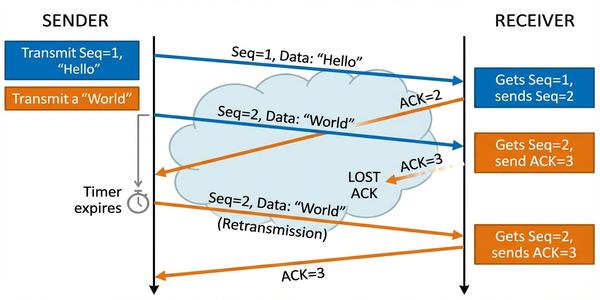
TCP: Segment, numery sekwencyjne i ACK
Cel slajdu: Slajd wyjaśnia numery sekwencyjne i potwierdzenia jako podstawę niezawodnego strumienia TCP.

Gwarancja porządku i dostarczenia

  • TCP dzieli strumień danych na mniejsze części zwane segmentami.
  • Każdy bajt w strumieniu danych jest numerowany, a każdy segment w swoim nagłówku przenosi numer sekwencyjny (Sequence Number) pierwszego bajtu danych w tym segmencie.
  • Dzięki temu odbiorca potrafi złożyć segmenty z powrotem w odpowiedniej kolejności, nawet jeśli pakiety IP dotarły w innym porządku.
  • Aby zagwarantować dostarczenie, odbiorca po otrzymaniu segmentu odsyła potwierdzenie (Acknowledgement - ACK), w którym podaje numer sekwencyjny następnego bajtu, jakiego się spodziewa.
  • Jeśli nadawca nie otrzyma ACK w określonym czasie, retransmituje brakujący segment.
Numery sekwencyjne i potwierdzenia ACK: Strumień bajtów jest dzielony na segmenty z numerami pierwszego bajtu, co pozwala odbiorcy złożyć dane w kolejności mimo innej kolejności pakietów IP. Potwierdzenie ACK niesie numer następnego oczekiwanego bajtu, a brak potwierdzenia po upływie limitu RTO wywołuje retransmisję. W WLAN częste przestawienia i zmienne opóźnienia utrudniają dobór tego limitu.
TCP: Segment, Numery Sekwencyjne i ACK

Segmentacja strumienia danych w protokole TCP polega na podzieleniu ciągłego strumienia bajtów na mniejsze jednostki, które są przekazywane do warstwy sieciowej w postaci segmentów. Każdy segment opatrzony jest numerem sekwencyjnym odpowiadającym pozycji pierwszego bajtu danych w segmencie w stosunku do całego strumienia. Dzięki temu odbiorca może składać odebrane segmenty we właściwej kolejności, nawet jeśli pakiety dotarły w innej kolejności, co w sieciach WLAN zdarza się częściej niż w sieciach przewodowych ze względu na zmienne warunki propagacji.

Potwierdzenia ACK pełnią rolę mechanizmu informacji zwrotnej, umożliwiając nadawcy monitorowanie skuteczności transmisji i reagowanie na ewentualne problemy. W standardowym działaniu TCP odbiorca wysyła potwierdzenie dla każdego odebranego segmentu lub, w ramach optymalizacji, co drugiego segmentu. Jeśli nadawca nie otrzyma potwierdzenia w określonym czasie, nazywanym czasem oczekiwania na retransmisję, uruchamiana jest procedura ponownego wysłania segmentu. W sieciach WLAN dobór odpowiedniego czasu oczekiwania na retransmisję jest wyzwaniem, ponieważ opóźnienia mogą się zmieniać dynamicznie w zależności od obciążenia kanału radiowego.

8/58
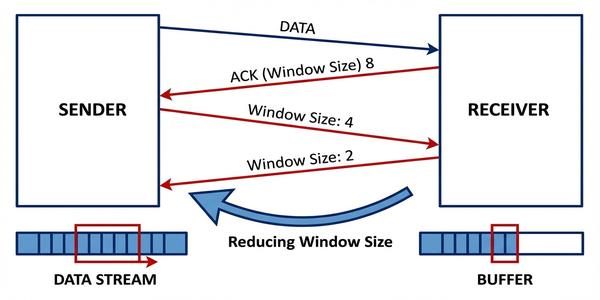
TCP: Kontrola Przepływu (Flow Control)
Cel slajdu: Slajd przedstawia kontrolę przepływu oknem przesuwnym jako ochronę wolnego odbiorcy przed zalaniem.

"Mów wolniej, nie nadążam!"

  • TCP implementuje mechanizm kontroli przepływu, aby zapobiec sytuacji, w której szybki nadawca "zalewa" danymi wolniejszego odbiorcę, prowadząc do przepełnienia jego buforów i utraty danych.
  • Służy do tego mechanizm okna przesuwnego (Sliding Window).
  • W każdym wysyłanym segmencie ACK, odbiorca informuje nadawcę, ile ma jeszcze wolnego miejsca w swoim buforze.
  • Wartość ta, zwana rozmiarem okna (Window Size), mówi nadawcy, ile danych może wysłać, zanim będzie musiał czekać na kolejne potwierdzenie.
  • Jeśli bufor odbiorcy zaczyna się zapełniać, ogłasza on mniejszy rozmiar okna, co zmusza nadawcę do zwolnienia transmisji.
Kontrola przepływu i okno przesuwne (ang. flow control, sliding window): Odbiorca ogłasza w potwierdzeniach rozmiar okna, czyli wolne miejsce w buforze, a nadawca nie wysyła więcej niż to okno. Okno zerowe wstrzymuje transmisję do czasu zwolnienia bufora. Mechanizm chroni słabe urządzenia mobilne w heterogenicznych sieciach WLAN przed zgubieniem danych z przepełnienia.
TCP: Kontrola Przepływu (Flow Control)

Kontrola przepływu w protokole TCP zapobiega przepełnieniu buforów odbiorcy poprzez dynamiczne dostosowywanie szybkości transmisji do możliwości przetwarzania strony odbierającej. Mechanizm ten opiera się na polu rozmiaru okna w nagłówku TCP, które informuje nadawcę o wolnej przestrzeni w buforze odbiorcy. Gdy odbiorca przetwarza dane wolniej, niż napływają, ogłasza mniejszy rozmiar okna, wymuszając na nadawcy zmniejszenie liczby przesyłanych jednocześnie segmentów. W skrajnym przypadku, gdy bufor odbiorcy jest całkowicie zapełniony, ogłaszany jest rozmiar okna równy zero, co wstrzymuje transmisję do momentu zwolnienia miejsca.

W sieciach WLAN kontrola przepływu nabiera dodatkowego znaczenia, ponieważ urządzenia mobilne, takie jak smartfony czy tablety, mają ograniczone zasoby pamięci i mocy obliczeniowej w porównaniu do stacji roboczych. Intensywna transmisja danych przez łącze bezprzewodowe może szybko doprowadzić do wyczerpania buforów odbiornika, szczególnie gdy urządzenie jednocześnie wykonuje inne zadania obciążające procesor. Mechanizm okna przesuwnego w TCP zapewnia, że nadawca automatycznie dostosowuje się do możliwości odbiorcy, co w heterogenicznych sieciach WLAN, gdzie współistnieją urządzenia o różnej wydajności, jest kluczowe dla sprawiedliwego podziału pasma.

9/58
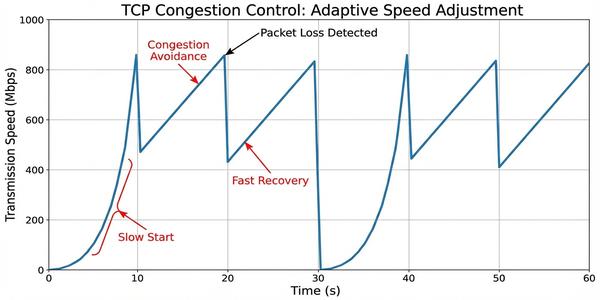
TCP: Kontrola Zatłoczenia (Congestion Control)
Cel slajdu: Slajd opisuje kontrolę zatłoczenia jako grzeczne dostosowanie tempa do wydolności routerów.

Dostosowanie do warunków w sieci

  • Oprócz kontroli przepływu (dostosowanie do odbiorcy), TCP musi również radzić sobie z zatłoczeniem (congestion) w samej sieci, czyli na routerach pośredniczących.
  • Gdy routery są przeciążone, zaczynają gubić pakiety.
  • TCP interpretuje utratę pakietów (brak ACK) jako sygnał zatłoczenia.
  • W odpowiedzi, drastycznie zmniejsza swoją szybkość nadawania (zmniejsza tzw. okno zatłoczenia - Congestion Window), a następnie powoli, wykładniczo (algorytm Slow Start), a potem liniowo, próbuje ją znowu zwiększać, badając, na ile "pozwala" sieć.
  • Ten ciągły proces adaptacji sprawia, że TCP jest "grzecznym" protokołem, który stara się nie przeciążać Internetu.
Kontrola zatłoczenia (ang. congestion control, algorytmy Reno, CUBIC, BBR): Nadawca traktuje utratę pakietu jako sygnał przeciążenia i reguluje oknem zatłoczenia: zaczyna wykładniczo w fazie wolnego startu, potem liniowo w fazie unikania. Nowoczesny algorytm BBR estymuje pasmo i opóźnienie zamiast ślepo ciąć okno, co lepiej sprawdza się w WLAN. Dzięki temu TCP nie przeciąża Internetu, a wybór algorytmu konfiguruje się nawet w Linuksie.
TCP: Kontrola Zatłoczenia (Congestion Control)

Kontrola zatłoczenia w protokole TCP stanowi mechanizm adaptacji do warunków panujących w sieci, chroniący infrastrukturę przed przeciążeniem poprzez zmniejszenie szybkości nadawania w odpowiedzi na utratę pakietów. W klasycznej implementacji TCP Reno algorytm działa w kilku fazach: powolnego startu, unikania zatłoczenia, szybkiej retransmisji i szybkiego odzyskiwania. Podczas powolnego startu rozmiar okna zatłoczenia zwiększa się wykładniczo aż do osiągnięcia progu, po czym następuje faza unikania zatłoczenia z liniowym wzrostem. W sieciach WLAN ten mechanizm może być źródłem problemów, ponieważ utrata pakietów rzadko wynika z rzeczywistego przeciążenia routerów, a znacznie częściej z przejściowych zakłóceń radiowych.

Nowoczesne algorytmy kontroli zatłoczenia, takie jak CUBIC, BBR czy NewReno, próbują lepiej radzić sobie z różnorodnymi warunkami sieciowymi, w tym z charakterystyką łączy bezprzewodowych. Algorytm BBR opracowany przez Google opiera się na szacowaniu dostępnej przepustowości i minimalnego opóźnienia, zamiast reagować na utratę pakietów, co czyni go bardziej odpowiednim dla sieci WLAN. W systemie Linux domyślny algorytm kontroli zatłoczenia można zmienić za pomocą parametru jądra net.ipv4.tcp_congestion_control, co pozwala administratorom dostosować działanie TCP do specyfiki ich środowiska sieciowego.

10/58
Wpływ Wi-Fi na działanie TCP
Cel slajdu: Slajd wyjaśnia, dlaczego TCP mylnie bierze straty radiowe za zatłoczenie i niepotrzebnie zwalnia.

Gdy utrata pakietu nie oznacza zatłoczenia

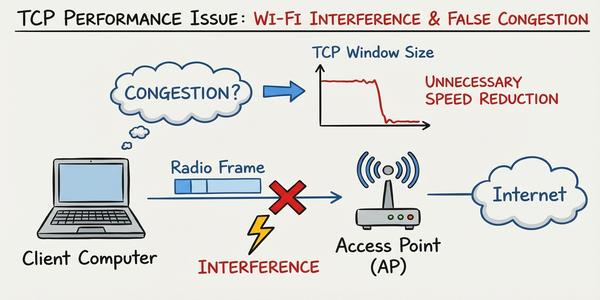
  • Mechanizmy kontroli zatłoczenia TCP zostały zaprojektowane z myślą o sieciach przewodowych, gdzie utrata pakietów jest rzadka i prawie zawsze oznacza przeciążenie routera.
  • W sieciach Wi-Fi jest inaczej – pakiety są często gubione z powodu zakłóceń, kolizji czy słabego sygnału, a nie zatłoczenia w Internecie.
  • Niestety, standardowy TCP nie potrafi tego rozróżnić.
  • Dla niego utrata ramki Wi-Fi (i brak ACK) to sygnał, że sieć jest zapchana, co powoduje niepotrzebne i drastyczne spowolnienie transmisji.
  • Jest to fundamentalny problem wydajnościowy, który próbuje się rozwiązywać za pomocą różnych algorytmów optymalizujących działanie TCP w środowiskach bezprzewodowych.
Problem TCP w sieciach bezprzewodowych: Protokół projektowano dla kabli, gdzie utrata oznacza przepełnione kolejki routerów, natomiast w Wi-Fi straty wynikają z zakłóceń, kolizji i słabego sygnału przy pustych kolejkach. Reakcją jest niepotrzebne cięcie okna i spadek przepływności. Remedia to priorytetyzacja WMM, jawne powiadamianie o zatłoczeniu ECN oraz akceleracja TCP z buforowaniem na kontrolerach.
Wpływ Wi-Fi na działanie TCP

Problem niewłaściwej interpretacji utraty pakietów w sieciach WLAN przez mechanizmy kontroli zatłoczenia TCP jest dobrze znany w środowisku inżynierów sieciowych i stanowi przedmiot wielu badań oraz optymalizacji. W klasycznej sieci Ethernet przewodowej utrata pakietu jest niemal zawsze sygnałem przeciążenia, ponieważ poziom szumów i zakłóceń jest minimalny, a błędy transmisji zdarzają się niezwykle rzadko. W sieci Wi-Fi natomiast, gdzie medium transmisyjne jest współdzielone i podatne na interferencje, utrata ramki 802.11 jest zjawiskiem normalnym i nie musi oznaczać przeciążenia infrastruktury. TCP, nie będąc w stanie odróżnić tych dwóch sytuacji, reaguje na każdą utratę pakietu zmniejszeniem okna zatłoczenia, co prowadzi do niepotrzebnego spadku przepustowości.

Rozwiązaniem tego problemu jest stosowanie mechanizmów jawnego powiadamiania o zatłoczeniu opartych na standardzie IEEE 802.11e oraz WMM, które umożliwiają punktom dostępowym oznaczanie ramek różnymi priorytetami jakości usług. Dodatkowo protokół TCP może korzystać z rozszerzenia ECN, które pozwala routerom na bezpośrednie poinformowanie nadawcy o zbliżającym się przeciążeniu, zanim dojdzie do utraty pakietów. W niektórych wdrożeniach stosuje się również techniki akceleracji TCP, takie jak pośrednie buforowanie na kontrolerach WLAN, które przechwytują i potwierdzają segmenty w imieniu urządzenia końcowego, maskując przed TCP chwilowe problemy z łączem radiowym.

11/58
UDP: Protokół "wyślij i zapomnij"
Cel slajdu: Slajd przedstawia protokół UDP jako minimalistyczne wyślij i zapomnij bez połączeń i potwierdzeń.

Szybkość ponad wszystko

  • UDP (User Datagram Protocol) to drugi, znacznie prostszy protokół warstwy transportowej.
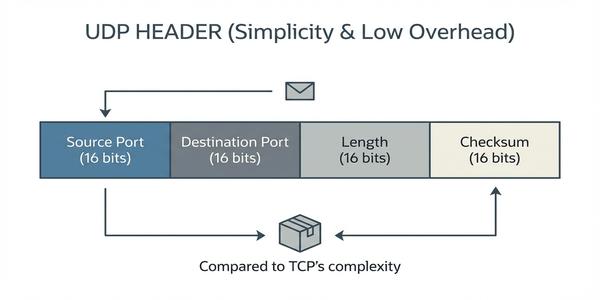
  • Jest bezpołączeniowy – po prostu bierze dane od aplikacji, pakuje je w jednostkę zwaną datagramem, dodaje bardzo prosty nagłówek (zawierający tylko porty źródłowy i docelowy oraz sumę kontrolną) i przekazuje do warstwy IP.
  • UDP nie numeruje datagramów, nie potwierdza ich odbioru, nie porządkuje i nie kontroluje przepływu.
  • Jest szybki, lekki i ma minimalny narzut.
  • Cała odpowiedzialność za ewentualne sprawdzenie, czy dane dotarły i czy są w dobrej kolejności, jest przerzucona na aplikację.
Protokół UDP (ang. User Datagram Protocol, RFC 768 z 1980 roku): Protokół wysyła samodzielne datagramy z nagłówkiem czterech 16-bitowych pól: porty, długość i suma kontrolna, obowiązkowa w IPv6. Nie ma numeracji, potwierdzeń, kolejności ani kontroli przepływu, więc odpowiedzialność spada na aplikację. Jest idealny dla głosu, obrazu i gier, gdzie tolerowana utrata ustępuje krytycznemu opóźnieniu.
UDP: Protokół 'wyślij i zapomnij'

User Datagram Protocol został zdefiniowany w dokumencie RFC 768 w roku 1980 i od tego czasu pozostaje praktycznie niezmieniony, co świadczy o prostocie i uniwersalności tego projektu. Nagłówek UDP składa się z zaledwie czterech pól szesnastobitowych: portu źródłowego, portu docelowego, długości datagramu oraz sumy kontrolnej. Suma kontrolna w UDP jest opcjonalna w protokole IPv4, ale w IPv6 stała się obowiązkowa, co ma na celu ochronę integralności danych w środowisku, gdzie fałszywe pakiety mogą być łatwiej wprowadzane do sieci. Brak numerów sekwencyjnych i potwierdzeń sprawia, że UDP nie może samodzielnie poradzić sobie z utratą, zdublowaniem lub zmianą kolejności datagramów.

W sieciach WLAN protokół UDP jest szczególnie ważny dla działania takich usług jak Voice over IP, strumieniowanie wideo oraz gry online. Aplikacje VoIP używające protokołu RTP na UDP mogą tolerować utratę nawet kilku procent pakietów bez odczuwalnego pogorszenia jakości rozmowy, dzięki zastosowaniu kodeków z mechanizmami ukrywania błędów. W przypadku transmisji strumieniowej wideo utrata pakietów UDP objawia się jako krótkotrwałe zniekształcenia obrazu, które znikają po otrzymaniu następnej klatki, podczas gdy retransmisja TCP spowodowałaby nieakceptowalne opóźnienie.

12/58
Zastosowania UDP
Cel slajdu: Slajd pokazuje kluczowe zastosowania UDP: czas rzeczywisty, DNS i DHCP w sieciach mobilnych.

Kiedy strata nie jest katastrofą?

  • Kiedy chcielibyśmy używać zawodnego protokołu?
  • Wszędzie tam, gdzie szybkość i minimalne opóźnienia są ważniejsze niż 100% niezawodność.
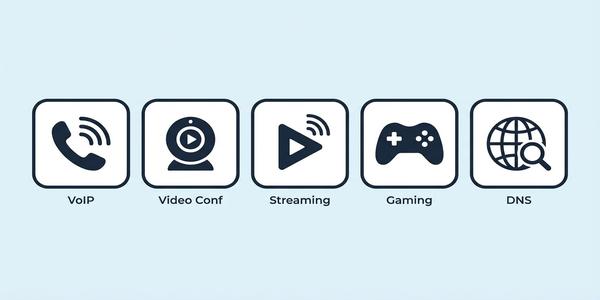
  • UDP jest idealny dla aplikacji czasu rzeczywistego.
  • W rozmowie VoIP lub wideokonferencji, utrata jednego małego pakietu z próbką dźwięku spowoduje co najwyżej krótkie, prawie niesłyszalne zakłócenie.
  • Czekanie na retransmisję tego pakietu (jak w TCP) byłoby bezsensowne, bo dźwięk i tak dotarłby z opóźnieniem.
  • Podobnie w grach online – informacja o pozycji gracza sprzed pół sekundy jest bezużyteczna; liczy się jak najszybciejsze dostarczenie tej aktualnej.
  • UDP jest również używane w prostych protokołach typu zapytanie-odpowiedź, jak DNS i DHCP.
Zastosowania UDP (VoIP, DNS, DHCP): Ruch czasu rzeczywistego, taki jak VoIP i wideokonferencje, woli zgubić milisekundy dźwięku niż czekać na retransmisję. System DNS pyta zwykle przez UDP na porcie 53 z rozszerzeniem do około 4096 bajtów, a DHCP konfiguruje adresy przez porty 67 i 68. W WLAN opóźnienia tych usług są odczuwalne jako wolne ładowanie stron i długie łączenie z siecią.
Zastosowania UDP

DNS, czyli system nazw domenowych, jest jednym z najważniejszych przykładów zastosowania protokołu UDP w codziennej pracy sieci. Zapytanie DNS składa się zazwyczaj z pojedynczego datagramu UDP, który jest wysyłany na port 53 serwera DNS, a odpowiedź zwracana jest również jako pojedynczy datagram. Historycznie limit odpowiedzi DNS po UDP wynosił 512 bajtów. Współcześnie mechanizm EDNS(0) (RFC 6891) pozwala na przesyłanie znacznie większych datagramów (typowo do 4096 bajtów). Gdy rozmiar odpowiedzi przekracza dozwolony limit, protokół przełącza się na TCP. W sieciach WLAN opóźnienia związane z rozwiązywaniem nazw DNS mogą być odczuwalne przez użytkowników jako wydłużony czas ładowania stron internetowych, szczególnie gdy serwer DNS jest skonfigurowany nieprawidłowo lub znajduje się w odległej lokalizacji.

DHCP również korzysta z UDP do komunikacji między klientem a serwerem. Klient DHCP wysyła wiadomość Discover na adres rozgłoszeniowy z portu 68 na port 67, a serwer odpowiada Offer na port 68 klienta. Proces ten jest szczególnie ważny w sieciach WLAN, ponieważ urządzenia mobilne łączą się z nowymi sieciami i muszą szybko uzyskać konfigurację adresową. Protokół DHCP oferuje również opcję przedłużenia dzierżawy, co pozwala urządzeniom pozostającym w sieci na utrzymanie tego samego adresu IP bez konieczności ponawiania pełnej procedury przydziału.

13/58
TCP vs. UDP: Podsumowanie
Cel slajdu: Slajd podsumowuje kryteria wyboru między TCP a UDP oraz wskazuje protokoły hybrydowe.

Wybór odpowiedniego narzędzia

  • Podsumowując, wybór między TCP a UDP to fundamentalna decyzja architektoniczna dla każdej aplikacji sieciowej.
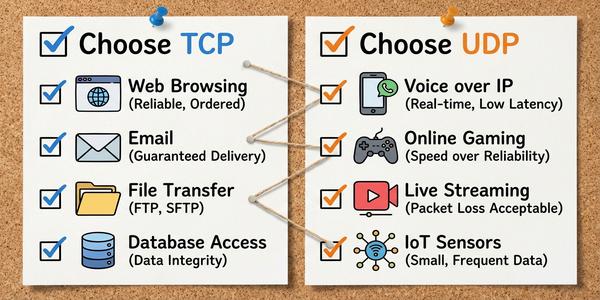
  • Jeśli aplikacja wymaga absolutnej pewności, że wszystkie dane dotrą w nienaruszonym stanie i w poprawnej kolejności, wybór jest prosty: TCP.
  • Jest to przypadek przeglądarek WWW, klientów poczty, transferu plików (FTP) czy terminali (SSH).
  • Jeśli natomiast aplikacja jest wrażliwa na opóźnienia, a utrata niewielkiej części danych jest akceptowalna, lub jeśli sama aplikacja implementuje własne mechanizmy niezawodności, wtedy znacznie lepszym wyborem będzie szybkie i lekkie UDP.
Wybór TCP albo UDP: TCP wybiera się dla integralności i kolejności: stron WWW, poczty, plików i SSH. UDP wybiera się dla niskich opóźnień przy tolerowanej utracie: głosu, gier, DNS i DHCP. Kryteria to tolerancja strat, wrażliwość na opóźnienia oraz własna niezawodność aplikacji. Hybrydy pokroju SCTP z wieloma strumieniami albo QUIC na UDP łączą oba światy.
TCP vs. UDP: Podsumowanie

Podczas wyboru między protokołem TCP a UDP należy uwzględnić kilka kluczowych kryteriów, takich jak tolerancja na utratę danych, wymagania co do opóźnień, konieczność zachowania kolejności oraz możliwość implementacji własnych mechanizmów niezawodności po stronie aplikacji. TCP jest niezbędny wszędzie tam, gdzie integralność danych ma absolutny priorytet, na przykład podczas transferu plików, wysyłania wiadomości e-mail czy wykonywania zdalnych połączeń SSH. UDP natomiast sprawdza się w aplikacjach czasu rzeczywistego, takich jak VoIP, wideokonferencje i gry sieciowe, gdzie opóźnienie ma większe znaczenie niż kompletność danych.

W nowoczesnych sieciach WLAN obserwuje się trend tworzenia protokołów hybrydowych, które łączą cechy TCP i UDP w zależności od potrzeb. Przykładem jest protokół SCTP, który oferuje niezawodną transmisję z możliwością dostarczania danych w wielu strumieniach, co zapobiega blokowaniu się kolejnych transmisji w przypadku utraty pojedynczego pakietu. Protokół QUIC, działający na UDP, implementuje własne mechanizmy niezawodności i kontroli zatłoczenia, oferując lepszą wydajność niż klasyczne TCP w środowiskach o zmiennych warunkach transmisji, takich jak sieci bezprzewodowe.

14/58
QUIC: Nowoczesna alternatywa?
Cel slajdu: Slajd przedstawia protokół QUIC jako nowoczesną niezawodność na UDP z migracją połączenia przy roamingu.

Najlepsze z obu światów

  • W ostatnich latach na popularności zyskuje nowy protokół warstwy transportowej, opracowany przez Google, o nazwie QUIC (Quick UDP Internet Connections).
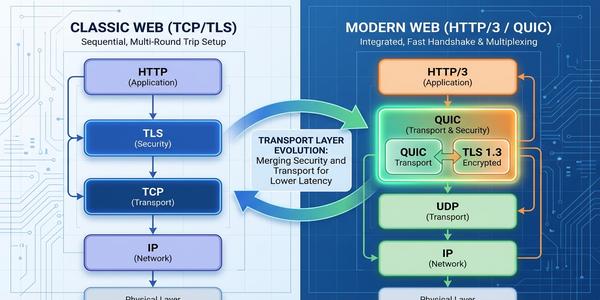
  • Działa on "na wierzchu" UDP, ale implementuje wiele zaawansowanych funkcji znanych z TCP, takich jak niezawodność, kontrola zatłoczenia i porządkowanie strumieni – robi to jednak w znacznie bardziej nowoczesny i wydajny sposób.
  • QUIC domyślnie szyfruje całą transmisję, nawiązuje połączenie znacznie szybciej niż TCP (w jednym obiegu) i lepiej radzi sobie ze zmianami sieci (np. przełączeniem z Wi-Fi na LTE).
  • Jest on fundamentem protokołu HTTP/3 i coraz szerzej zastępuje klasyczne połączenia TCP w nowoczesnych usługach internetowych.
Protokół QUIC (RFC 9000): Protokół opracowany w Google przenosi niezawodność i kontrolę zatłoczenia nowocześniejszą niż TCP na datagramy UDP, z domyślnym szyfrowaniem i połączonym uzgodnieniem bezpieczeństwa w jednym obrocie. Identyfikator połączenia zamiast adresu IP zapewnia migrację sesji przy roamingu między Wi-Fi a LTE. Stanowi fundament protokołu HTTP/3 i obsługi ruchu w przeglądarce Chrome.
QUIC: Nowoczesna alternatywa?

Protokół QUIC, opracowany przez Google i znormalizowany w dokumencie RFC 9000, stanowi przełom w komunikacji transportowej, łącząc zalety TCP i UDP z nowoczesnym podejściem do bezpieczeństwa i wydajności. W odróżnieniu od TCP, które wymaga oddzielnego uzgadniania połączenia i sesji TLS, QUIC łączy te dwa procesy w jeden obieg, co skraca czas nawiązywania połączenia z dwóch do jednego obiegu. W sieciach WLAN, gdzie opóźnienia dostępu do medium mogą być znaczące, to przyspieszenie ma bezpośrednie przełożenie na komfort użytkowania, szczególnie przy częstym otwieraniu nowych sesji, na przykład podczas przeglądania stron internetowych.

Jedną z kluczowych cech QUIC jest wbudowane szyfrowanie warstwy transportowej, które zabezpiecza nie tylko dane użytkownika, ale również pakiety kontrolne, takie jak potwierdzenia i sygnały sterowania przepływem. W przeciwieństwie do TCP, gdzie nagłówki są przesyłane jawnym tekstem i mogą być analizowane przez urządzenia pośrednie, QUIC szyfruje większość swoich nagłówków, co zwiększa prywatność użytkowników w sieciach WLAN. Protokół QUIC jest obecnie szeroko stosowany w przeglądarce Google Chrome, a jego obsługa jest stopniowo dodawana do serwerów WWW i platform strumieniowania wideo.

W kontekście sieci WLAN szczególnie istotny jest mechanizm Connection Migration w protokole QUIC. Gdy urządzenie mobilne przemieszcza się między punktami dostępowymi (roaming) lub chwilowo traci zasięg, sesje TCP muszą być zestawiane od nowa. QUIC natomiast identyfikuje połączenie nie po adresie IP i porcie, lecz po unikalnym identyfikatorze połączenia (Connection ID), co pozwala na płynną kontynuację transmisji po zmianie sieci.

15/58
Warstwa 5: Warstwa sesji
Cel slajdu: Slajd wprowadza warstwę sesji jako zarządcę dialogów z punktami kontrolnymi i formalnym zakończeniem.

Zarządca dialogu

  • Wchodzimy na terytorium warstw, których funkcje w nowoczesnym internecie są często wchłaniane przez warstwę aplikacji.
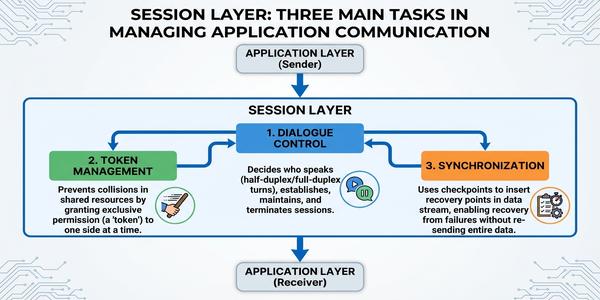
  • Teoretycznie, warstwa sesji jest odpowiedzialna za nawiązywanie, zarządzanie i kończenie sesji, czyli dialogów między aplikacjami na dwóch różnych hostach.
  • Można ją przyrównać do reżysera rozmowy: dba o to, kto mówi teraz (kontrola dialogu), umieszcza "punkty kontrolne" w długiej transmisji, aby w razie awarii nie trzeba było zaczynać od początku (synchronizacja), i formalnie kończy rozmowę.
  • W praktyce, większość tych zadań realizują same protokoły aplikacyjne, a warstwa sesji jako oddzielny byt rzadko występuje.
Warstwa sesji, warstwa 5 (ang. session layer): Warstwa odpowiada za nawiązywanie, podtrzymywanie i kończenie sesji dialogowych między aplikacjami, z kontrolą kolejności wypowiedzi, punktami synchronizacji do wznowienia po awarii oraz formalnym zamknięciem. W praktyce została wchłonięta przez biblioteki warstwy aplikacji. W WLAN jej funkcje odzywają się przy roamingu i odtwarzaniu sesji po utracie radia.
Warstwa 5: Warstwa Sesji

Warstwa sesji modelu OSI jest odpowiedzialna za organizację i synchronizację dialogu między aplikacjami działającymi na różnych hostach, zapewniając logiczne ramy dla wymiany danych. W praktyce nowoczesnych sieci komputerowych warstwa sesji rzadko funkcjonuje jako wyodrębniona jednostka, ponieważ większość jej funkcji została wchłonięta przez protokoły warstwy aplikacji lub jest realizowana bezpośrednio przez biblioteki programistyczne. Niemniej jednak zrozumienie koncepcji sesji jest niezbędne do projektowania systemów rozproszonych i analizy złożonych protokołów komunikacyjnych. Mechanizmy punktów kontrolnych używane w warstwie sesji pozwalają na wznowienie transmisji z miejsca przerwania, co w sieciach WLAN o zmiennej jakości połączenia ma praktyczne znaczenie.

Przykładem protokołu implementującego koncepcję sesji jest NetBIOS, który był szeroko stosowany w starszych sieciach opartych na systemach Windows. Współcześnie koncepcje sesji są realizowane przez mechanizmy cookie i tokeny w aplikacjach webowych oraz przez protokół SIP w telefonii internetowej. W kontekście sieci WLAN zarządzanie sesjami nabiera szczególnego znaczenia przy obsłudze roamingu, ponieważ aplikacje muszą utrzymać ciągłość dialogu między klientem a serwerem pomimo zmiany punktu dostępowego.

16/58
Analogia do warstwy sesji
Cel slajdu: Slajd tłumaczy ideę sesji analogią rozmowy telefonicznej z powitaniem, podsumowaniami i rozłączeniem.

Sesja jako rozmowa telefoniczna

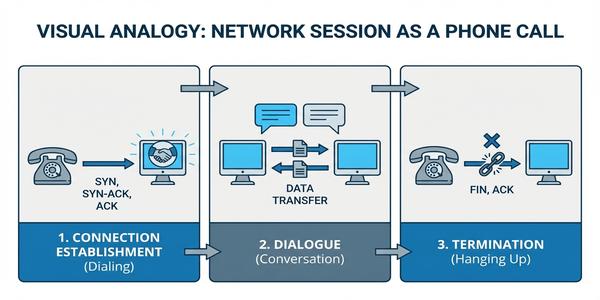
  • Dobrą analogią do działania warstwy sesji jest klasyczna rozmowa telefoniczna.
  • Nawiązanie sesji: Wykręcenie numeru, oczekiwanie na sygnał, druga osoba odbiera i mówi "halo".
  • Zarządzanie sesją: Obie strony prowadzą dialog. Wiadomo, kto mówi, a kto słucha. Jeśli rozmowa jest długa i dotyczy ważnych spraw, co jakiś czas podsumowujemy: "OK, czyli do tej pory uzgodniliśmy, że...". To są właśnie punkty kontrolne.
  • Zakończenie sesji: Jedna ze stron mówi "do usłyszenia" i odkłada słuchawkę. Połączenie jest formalnie zrywane.
  • Warstwa sesji zapewnia, że ten logiczny dialog między aplikacjami przebiega w sposób uporządkowany.
Analogia sesji do rozmowy telefonicznej: Sesję otwiera powitanie odpowiadające nawiązaniu połączenia, dialog przerywają podsumowania jak punkty kontrolne, a rozmowę kończy odłożenie słuchawki jak formalne zamknięcie. Porządek ten nadaje sens logicznemu dialogowi aplikacji. Przerwa w sygnale radiowym gubi kontekst i wymusza ponowne uwierzytelnienie, co pokazuje cenę braku trwałej sesji.
Analogia do Warstwy Sesji

Analogie do codziennych sytuacji ułatwiają zrozumienie abstrakcyjnych koncepcji warstwy sesji, która w modelu OSI pełni funkcję organizatora dialogu między aplikacjami. W rozmowie telefonicznej naturalnie występują fazy: inicjacja połączenia, właściwa rozmowa i zakończenie, które odpowiadają funkcjom warstwy sesji. W sieciach WLAN analogia ta nabiera dodatkowego wymiaru, gdyż przerwanie połączenia radiowego może doprowadzić do utraty kontekstu sesji i konieczności ponownej autoryzacji użytkownika. Warstwa sesji w idealnym modelu powinna zapewnić mechanizmy umożliwiające płynne odtworzenie sesji po chwilowej utracie łączności.

Punkty kontrolne w warstwie sesji działają jak kamienie milowe w długiej rozmowie, pozwalając na powrót do ostatniego potwierdzonego punktu w razie przerwania komunikacji. W praktycznych zastosowaniach, takich jak przesyłanie dużych plików między serwerami w sieci rozległej, mechanizmy sesyjne umożliwiają wznowienie transmisji zamiast rozpoczynania od początku po wystąpieniu błędu. Koncepcja sesji znajduje odzwierciedlenie w wielu współczesnych protokołach, gdzie stan sesji jest przechowywany na serwerze i identyfikowany za pomocą unikalnego identyfikatora sesji.

17/58
Praktyczne przykłady użycia Warstwy Sesji
Cel slajdu: Slajd pokazuje praktyczne wcielenia sesji: wywołania RPC, sygnalizację SIP i sesje serwisów internetowych.

Gdzie można spotkać warstwę 5?

  • Chociaż warstwa sesji nie jest tak wyraźnie widoczna jak inne, jej koncepcje można odnaleźć w wielu protokołach.
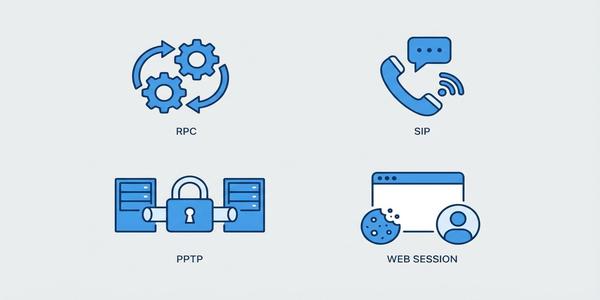
  • Przykładem mogą być zdalne wywołania procedur (RPC - Remote Procedure Call), gdzie program na jednym komputerze wywołuje funkcję na innym, jakby była ona lokalna.
  • Mechanizmy sesyjne dbają o to, by żądanie i odpowiedź były poprawnie sparowane.
  • Innym przykładem są protokoły używane w tele- i wideokonferencjach (np. SIP - Session Initiation Protocol), które jawnie nawiązują, modyfikują i kończą sesje multimedialne.
  • Nawet logowanie do systemu bankowego przez przeglądarkę tworzy "sesję" na poziomie aplikacji, która wygasa po pewnym czasie bezczynności.
Sesje w praktyce (RPC, SIP, sesje webowe): Wywołania zdalnych procedur parują żądanie z odpowiedzią i są wrażliwe na limity czasu w WLAN. Protokół SIP jawnie inicjuje, modyfikuje i kończy sesje multimedialne komunikatami INVITE i BYE. Serwisy internetowe utrzymują zalogowanie tokenami i ciasteczkami wygasającymi po bezczynności. Wszystkie muszą radzić sobie z utratą zasięgu w sieciach publicznych.
Praktyczne przykłady użycia Warstwy Sesji

Zdalne wywołania procedur są jednym z najstarszych i najbardziej rozpowszechnionych zastosowań koncepcji warstwy sesji w praktyce programistycznej. W modelu RPC program na jednym komputerze wywołuje funkcję na zdalnym hoście, a warstwa sesji dba o sparowanie żądania z odpowiedzią, nawet w przypadku wystąpienia wielu równoległych wywołań. W sieciach WLAN opóźnienia wprowadzane przez łącze radiowe mogą powodować przekroczenie limitów czasu oczekiwania na odpowiedź RPC, co wymaga starannego doboru parametrów timeout w aplikacjach korzystających z tego mechanizmu. Protokół SIP, używany w telefonii VoIP, implementuje pojęcie sesji w sposób najbardziej zbliżony do pierwotnej definicji warstwy sesji, jawnie nawiązując, modyfikując i kończąc sesje multimedialne.

Sesje uwierzytelniania w nowoczesnych aplikacjach webowych, choć nie są implementowane w warstwie sesji modelu OSI, wykorzystują te same koncepcje. Po zalogowaniu się do systemu bankowego serwer tworzy sesję identyfikowaną unikalnym tokenem, który jest ważny przez określony czas lub do momentu wylogowania. W publicznych sieciach WLAN zarządzanie sesjami uwierzytelniania jest szczególnie istotne, ponieważ użytkownicy mogą okresowo tracić zasięg i ponownie łączyć się z siecią, oczekując, że ich sesja pozostanie aktywna.

18/58
Warstwa 6: Warstwa Prezentacji
Cel slajdu: Slajd wprowadza warstwę prezentacji jako tłumacza formatów z szyfrowaniem i kompresją.

Uniwersalny tłumacz danych

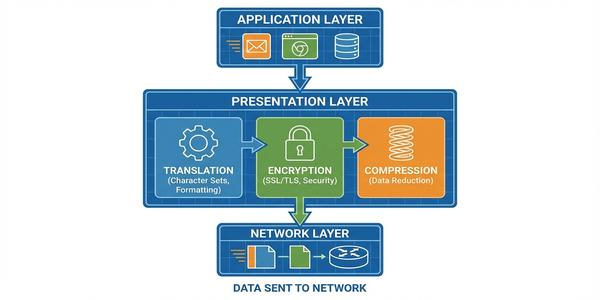
  • Zadaniem warstwy prezentacji jest zapewnienie, że dane wysłane przez warstwę aplikacji jednego systemu będą w pełni zrozumiałe dla warstwy aplikacji systemu docelowego.
  • Działa ona jak uniwersalny tłumacz i formater danych.
  • Odpowiada za trzy główne zadania.
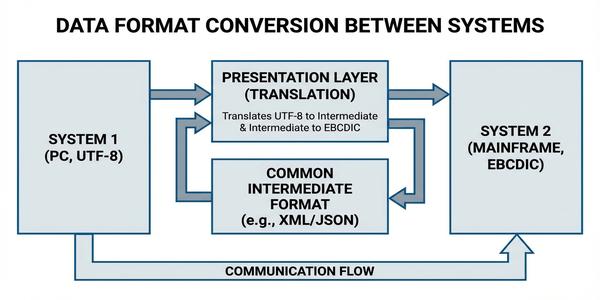
  • Po pierwsze, za tłumaczenie formatów, np. konwersję między różnymi systemami kodowania znaków (jak ASCII i EBCDIC).
  • Po drugie, za szyfrowanie i deszyfrowanie danych w locie, aby zapewnić poufność transmisji.
  • Po trzecie, za kompresję i dekompresję, w celu zmniejszenia ilości przesyłanych danych i oszczędności pasma.
Warstwa prezentacji, warstwa 6 (ang. presentation layer): Warstwa zapewnia wzajemną zrozumiałość danych między różnymi systemami poprzez tłumaczenie formatów, szyfrowanie i kompresję. Rzadko występuje jako osobna implementacja, zwykle jako biblioteki pokroju OpenSSL i zlib. W WLAN kluczowe jest szyfrowanie TLS, a kompresja oszczędza drogie pasmo radiowe.
Warstwa 6: Warstwa Prezentacji

Warstwa prezentacji pełni funkcję tłumacza między formatem danych używanym przez aplikację a formatem standardowym, który jest przesyłany przez sieć. Zadanie to obejmuje trzy główne obszary: transformację kodowania znaków, szyfrowanie i deszyfrowanie oraz kompresję i dekompresję danych. W kontekście sieci WLAN rola warstwy prezentacji jest często pomijana, ponieważ większość współczesnych protokołów aplikacyjnych implementuje te funkcje samodzielnie. Niemniej jednak standardy takie jak TLS, które historycznie były przypisywane do warstwy prezentacji, odgrywają fundamentalną rolę w zabezpieczaniu komunikacji w sieciach bezprzewodowych.

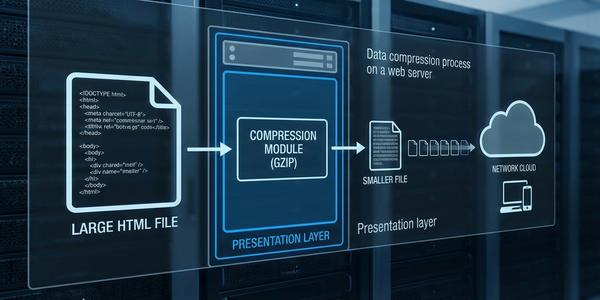
W praktyce programistycznej rzadko zdarza się, aby programista bezpośrednio implementował funkcje warstwy prezentacji, ponieważ są one dostarczane przez biblioteki systemowe i protokoły wyższych warstw. Na przykład biblioteka OpenSSL udostępnia funkcje szyfrowania i deszyfrowania, które są wykorzystywane przez serwery WWW do obsługi protokołu HTTPS. Podobnie biblioteki kompresji, takie jak zlib, są używane przez serwery do kompresowania treści HTML przed wysłaniem do przeglądarki. W sieciach WLAN kompresja danych ma szczególne znaczenie, ponieważ zmniejsza ilość danych przesyłanych przez ograniczone pasmo łącza radiowego.

19/58
Formatowanie i kodowanie danych
Cel slajdu: Slajd opisuje problem kodowania znaków i formatów pośrednich od ASN.1 przez XML po JSON.

Jak zapewnić, że "A" to zawsze "A"?

  • Różne systemy komputerowe mogą historycznie używać różnych sposobów reprezentacji danych.
  • Na przykład, komputery typu mainframe często używały kodowania znaków EBCDIC, podczas gdy większość współczesnych systemów używa ASCII lub Unicode (UTF-8).
  • Warstwa prezentacji dba o to, aby dane zostały przekonwertowane na wspólny, pośredni format (np. ASN.1 - Abstract Syntax Notation One) przed wysłaniem, a następnie z powrotem na format natywny po stronie odbiorcy.
  • W nowoczesnym internecie rolę takiego wspólnego formatu często pełnią standardy takie jak XML (eXtensible Markup Language) czy JSON (JavaScript Object Notation), które pozwalają na strukturalny i czytelny dla maszyn (i ludzi) opis danych.
Kodowanie danych i formaty pośrednie (ASCII, UTF-8, ASN.1, XML, JSON): Różne systemy kodowały znaki inaczej, od EBCDIC po ASCII, a dziś standardem jest Unicode UTF-8. Format pośredni, taki jak ASN.1 w telekomunikacji albo JSON w interfejsach REST, jest konwertowany z postaci natywnej na wspólną i z powrotem. Lekki JSON zdominował sieć, a wybór formatu balansuje między wydajnością a złożonością.
Formatowanie i kodowanie danych

Standaryzacja formatów danych na poziomie warstwy prezentacji rozwiązuje problem niekompatybilności między różnymi systemami komputerowymi, które mogą używać odmiennych sposobów reprezentacji tych samych informacji. Historycznie jednym z głównych wyzwań była różnica między kodowaniem ASCII stosowanym w systemach uniksowych a kodowaniem EBCDIC używanym w mainframach IBM. Współczesny standard Unicode w kodowaniu UTF-8 rozwiązał większość problemów związanych z kodowaniem znaków, umożliwiając jednoczesne używanie różnych alfabetów i symboli w ramach jednego dokumentu. W sieciach WLAN obsługa różnych kodowań ma znaczenie przy transmisji danych tekstowych między urządzeniami o różnych systemach operacyjnych i konfiguracjach językowych.

Formaty ASN.1, XML i JSON pełnią funkcję wspólnych języków opisu struktury danych, umożliwiając interoperacyjność między różnorodnymi systemami. ASN.1 jest używany w protokołach telekomunikacyjnych i w standardzie SNMP, XML dominuje w starszych systemach wymiany danych między aplikacjami biznesowymi, a JSON jest obecnie standardem dla nowoczesnych API REST. Wybór odpowiedniego formatu zależy od wymagań wydajnościowych i złożoności struktury danych, przy czym JSON jest preferowany w aplikacjach webowych ze względu na swoją lekkość i łatwość przetwarzania.

20/58
Szyfrowanie i deszyfrowanie (TLS/SSL)
Cel slajdu: Slajd przedstawia szyfrowanie TLS jako tunel chroniący ruch aplikacji przed podsłuchem w WLAN.

Zapewnienie poufności

  • Najważniejszą i najbardziej widoczną funkcją warstwy prezentacji we współczesnym internecie jest szyfrowanie.
  • Protokoły takie jak TLS (Transport Layer Security) i jego poprzednik SSL (Secure Sockets Layer) działają właśnie na tej warstwie.
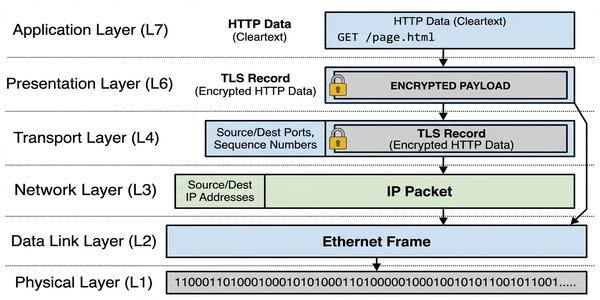
  • Kiedy łączymy się ze stroną banku przez HTTPS, to właśnie warstwa prezentacji w naszej przeglądarce inicjuje "uścisk dłoni" TLS z serwerem, negocjuje klucze szyfrujące, a następnie szyfruje wszystkie dane wysyłane przez aplikację (HTTP) przed przekazaniem ich do warstwy transportowej (TCP).
  • Po stronie serwera zachodzi proces odwrotny.
  • Dzięki temu cała komunikacja jest poufna i zabezpieczona przed podsłuchem.
Szyfrowanie TLS (ang. Transport Layer Security, RFC 8446 dla wersji 1.3): Protokół negocjuje wersję i algorytmy, weryfikuje certyfikaty i ustanawia klucz symetryczny, po czym HTTP podróżuje w zaszyfrowanym tunelu HTTPS. Jest krytyczne w WLAN wobec podsłuchu i ataków pośrednika w hotspotach. Wersja 1.3 skraca uzgodnienie do jednego obrotu, przyspieszając ładowanie stron.
Szyfrowanie i Deszyfrowanie (TLS/SSL)

Protokół TLS, wywodzący się z opracowanego przez Netscape protokołu SSL, stanowi fundament bezpiecznej komunikacji we współczesnym Internecie. W sieciach WLAN stosowanie TLS jest szczególnie ważne, ponieważ medium radiowe jest podatne na podsłuch, a każdy klient znajdujący się w zasięgu punktu dostępowego może przechwycić niezaszyfrowaną transmisję. TLS działa w dwóch fazach: w pierwszej fazie, zwanej uściskiem dłoni, klient i serwer negocjują wersję protokołu, algorytmy szyfrowania oraz wymieniają klucze publiczne. W drugiej fazie następuje właściwe szyfrowanie transmitowanych danych przy użyciu uzgodnionego klucza symetrycznego.

Uścisk dłoni TLS obejmuje wymianę certyfikatów cyfrowych, które są podpisywane przez zaufane urzędy certyfikacji, co umożliwia klientowi weryfikację tożsamości serwera. W przypadku korzystania z publicznej sieci WLAN, na przykład w hotelu lub na lotnisku, uwierzytelnienie serwera za pomocą certyfikatu TLS zapobiega atakom typu man-in-the-middle. Współczesna wersja TLS 1.3, zdefiniowana w dokumencie RFC 8446, znacząco skróciła czas nawiązywania połączenia do jednego obiegu, co w sieciach WLAN przekłada się na szybsze ładowanie stron i lepsze doświadczenia użytkownika.

21/58
Kompresja
Cel slajdu: Slajd omawia kompresję treści jako sposób oszczędzania pasma radiowego z pułapką ataku CRIME.

Mniej bitów, szybszy transfer

  • Kolejnym zadaniem warstwy prezentacji jest kompresja danych.
  • Przed wysłaniem, dane mogą zostać poddane algorytmom kompresji (takim jak gzip, deflate czy brotli), aby zmniejszyć ich objętość.
  • Mniejsza ilość danych oznacza szybszy transfer i mniejsze obciążenie sieci, co jest szczególnie ważne w sieciach o ograniczonej przepustowości, takich jak sieci komórkowe czy wolne połączenia Wi-Fi.
  • Po stronie odbiorcy, warstwa prezentacji musi oczywiście dokonać dekompresji, aby przywrócić dane do oryginalnej postaci, zanim przekaże je do aplikacji.
  • Kompresja jest powszechnie stosowana na przykład przez serwery WWW do zmniejszania rozmiaru plików HTML, CSS i JavaScript.
Kompresja danych (gzip, deflate, brotli): Algorytmy kompresują tekstowe HTML, CSS i JavaScript, przy czym brotli bywa o 20-30 procent skuteczniejszy niż gzip. Mniej bitów oznacza szybszy transfer i mniejsze obciążenie eteru, natomiast treści multimedialne są już skompresowane. Kompresji na poziomie TLS unika się z powodu ataku CRIME, stosując kodowanie treści w HTTP.
Kompresja

Kompresja danych na poziomie warstwy prezentacji ma na celu zmniejszenie objętości przesyłanych informacji poprzez usunięcie nadmiarowości przy jednoczesnym zachowaniu oryginalnej treści. Algorytmy kompresji bezstratnej, takie jak gzip, deflate czy brotli, są powszechnie stosowane przez serwery WWW do kompresji treści HTML, CSS i JavaScript. W sieciach WLAN, gdzie przepustowość łącza radiowego jest dzielona między wszystkich użytkowników, kompresja danych ma większe znaczenie niż w sieciach przewodowych, ponieważ pozwala na efektywniejsze wykorzystanie dostępnego pasma. Stopień kompresji zależy od rodzaju danych, przy czym pliki tekstowe i kody źródłowe osiągają współczynniki kompresji rzędu kilkudziesięciu procent, podczas gdy pliki multimedialne są już skompresowane i nie poddają się dalszej redukcji.

Kompresja w protokole TLS, realizowana przez rozszerzenie TLS Compression, jest obecnie rzadko stosowana ze względu na podatność na ataki kryptanalityczne, takie jak atak CRIME. Zamiast tego kompresję implementuje się na poziomie protokołu HTTP za pomocą mechanizmu Content-Encoding negocjowanego między klientem a serwerem. Współczesny algorytm brotli, opracowany przez Google, oferuje o dwadzieścia do trzydziestu procent lepszy stopień kompresji niż gzip, co w sieciach WLAN przekłada się na szybsze ładowanie stron internetowych.

22/58
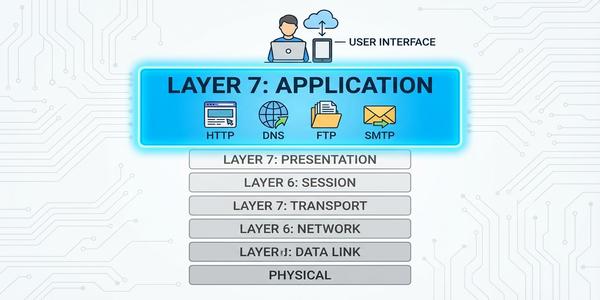
Warstwa 7: Warstwa Aplikacji
Cel slajdu: Slajd definiuje warstwę aplikacji jako protokoły służące programom, a nie same programy.

Interfejs do świata sieci

  • Wreszcie docieramy na sam szczyt: do warstwy aplikacji.
  • Jest to warstwa najbliższa użytkownikowi, ale uwaga – to nie jest sama aplikacja (jak Chrome czy Outlook)!
  • Jest to warstwa, która dostarcza protokoły sieciowe, z których te aplikacje korzystają, aby komunikować się przez sieć.
  • Innymi słowy, warstwa aplikacji definiuje reguły komunikacji dla konkretnych zadań: jak pobrać stronę WWW, jak wysłać e-mail, jak rozwiązać nazwę domeny.
  • Udostępnia ona interfejs programistyczny (API), który pozwala programistom na łatwe tworzenie aplikacji sieciowych bez martwienia się o szczegóły niższych warstw.
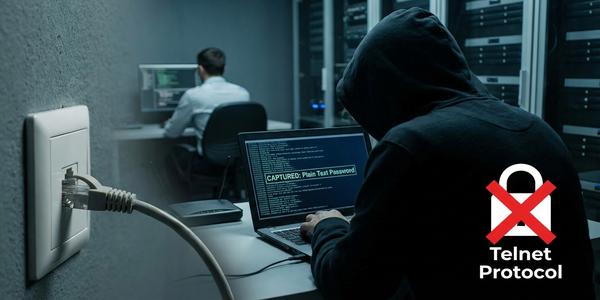
Warstwa aplikacji, warstwa 7 (ang. application layer): Warstwa definiuje składnię, sekwencje komunikatów i kody protokołów pokroju HTTP, DNS, DHCP, SMTP i FTP, z których korzystają programy poprzez interfejsy API. Sama aplikacja nie jest warstwą, lecz jej użytkownikiem. W WLAN jawnym tekstem protokołów pokroju FTP i Telnet grozi podsłuch radia, więc preferuje się odmiany szyfrowane.
Warstwa 7: Warstwa Aplikacji

Warstwa aplikacji modelu OSI jest najbardziej złożoną i zróżnicowaną spośród wszystkich warstw, ponieważ to na niej definiowane są protokoły obsługujące konkretne zadania użytkowników. W odróżnieniu od warstwy aplikacji w modelu TCP/IP, która łączy funkcje trzech górnych warstw OSI, w modelu referencyjnym warstwa siódma koncentruje się wyłącznie na interfejsie między aplikacją a protokołami sieciowymi. W sieciach WLAN protokoły warstwy aplikacji działają niezależnie od specyfiki medium transmisyjnego, ale ich wydajność jest pośrednio zależna od parametrów łącza radiowego, takich jak opóźnienie i przepustowość. Każdy z protokołów warstwy aplikacji definiuje własną składnię i semantykę komunikacji, w tym formaty nagłówków, sekwencje wiadomości i kody stanu.

Najważniejsze protokoły warstwy aplikacji obejmują HTTP dla usług WWW, DNS dla rozwiązywania nazw domenowych, DHCP dla automatycznej konfiguracji adresacji, SMTP dla poczty wychodzącej oraz FTP dla transferu plików. Każdy z tych protokołów działa na określonych portach TCP lub UDP i definiuje precyzyjny format wymienianych wiadomości. W kontekście bezpieczeństwa sieci WLAN niektóre z tych protokołów, szczególnie starsze takie jak FTP i Telnet, przesyłają dane w postaci jawnego tekstu, co stanowi poważne zagrożenie w środowisku bezprzewodowym podatnym na podsłuch.

23/58
Protokół HTTP/HTTPS
Cel slajdu: Slajd przedstawia protokół HTTP i jego ewolucję od wersji 1.1 przez multipleksowaną 2 po opartą na QUIC 3.

Język globalnej sieci

  • HTTP (Hypertext Transfer Protocol) to fundamentalny protokół warstwy aplikacji, na którym opiera się cała sieć World Wide Web.
  • Działa on w modelu klient-serwer.
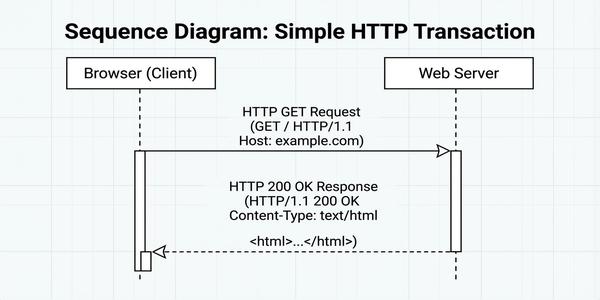
  • Przeglądarka (klient) wysyła do serwera WWW żądanie (HTTP Request), np. `GET /index.html`, prosząc o dany zasób.
  • Serwer przetwarza żądanie i odsyła odpowiedź (HTTP Response), która zawiera kod statusu (np. `200 OK`) oraz treść zasobu (np. kod HTML strony).
  • HTTPS (HTTP Secure) to po prostu protokół HTTP działający wewnątrz bezpiecznego, szyfrowanego tunelu TLS.
  • Cały ten proces, od wysłania żądania do otrzymania odpowiedzi, odbywa się oczywiście przez naszą sieć Wi-Fi.
Protokoły HTTP i HTTPS (RFC 9110, HTTP/2, HTTP/3 na QUIC): Klient wysyła żądanie GET ze ścieżką, a serwer odpowiada kodem 200 i dokumentem HTML. Wersja 1.1 stała się podstawą sieci, wersja 2 dodała multipleksację strumieni, a wersja 3 działa na QUIC przez UDP. Szyfrowanie TLS zapewnia poufność i integralność, a przeglądarki oznaczają strony bez niego jako niebezpieczne. W WLAN droga radiowa wydłuża czas obrotu i drenuje baterię.
Protokół HTTP/HTTPS

Protokół HTTP w wersji 1.1, zdefiniowany w dokumencie RFC 9110 i RFC 9112 (zastępujących wcześniejsze RFC 2616 i RFC 7230–7235), przez wiele lat stanowił podstawę komunikacji w sieci World Wide Web i pozostaje szeroko stosowany do dziś. Działa on w modelu żądanie-odpowiedź, gdzie klient wysyła do serwera żądanie zawierające metodę, URI oraz zestaw nagłówków, a serwer odpowiada kodem statusu i treścią zasobu. W sieciach WLAN każde żądanie HTTP musi pokonać drogę przez łącze radiowe, co wydłuża czas odpowiedzi i może powodować zwiększone zużycie baterii urządzeń mobilnych. Protokół HTTP/2, wprowadzony w roku 2015, rozwiązał wiele problemów wydajnościowych poprzedniej wersji, takich jak blokowanie głowy linii, poprzez wprowadzenie multipleksowania strumieni w ramach jednego połączenia TCP.

Protokół HTTPS, czyli HTTP działający w tunelu TLS, zapewnia poufność i integralność danych wymienianych między przeglądarką a serwerem. W sieciach WLAN stosowanie HTTPS jest szczególnie zalecane, ponieważ uniemożliwia on atakującym przechwycenie haseł, numerów kart kredytowych i innych danych wrażliwych przesyłanych przez niechronione łącze radiowe. Współczesne przeglądarki internetowe oznaczają połączenia HTTP jako niebezpieczne, co motywuje właścicieli serwisów WWW do migracji na HTTPS. Protokół HTTP/3, oparty na QUIC i UDP, oferuje dalsze ulepszenia wydajności w sieciach o zmiennych opóźnieniach, takich jak WLAN.

24/58
Protokół DNS (ponownie)
Cel slajdu: Slajd wraca do DNS jako protokołu warstwy aplikacji z zagrożeniami zatruwania cache i szyfrowanymi odmianami.

Rola DNS w warstwie aplikacji

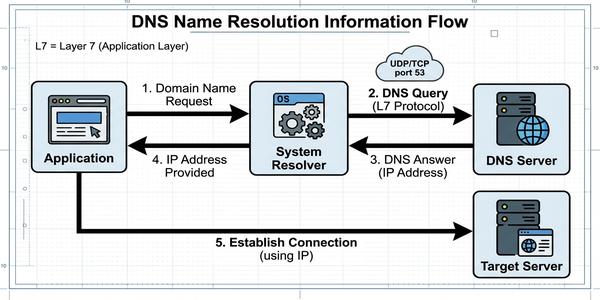
  • Chociaż o DNS mówiliśmy już przy warstwie sieciowej (bo jest niezbędny do uzyskania adresu IP), sam protokół DNS jest protokołem warstwy aplikacji.
  • Definiuje on format zapytań i odpowiedzi, które aplikacje (a konkretnie, systemowy resolver) wysyłają do serwerów DNS.
  • Zapytanie DNS to prosta wiadomość, zazwyczaj wysyłana przez UDP na port 53, zawierająca nazwę domeny, o którą pytamy.
  • Odpowiedź zawiera znaleziony adres IP lub informację o błędzie.
  • Proces ten, zwany rozwiązywaniem nazwy, musi zajść przed nawiązaniem niemal każdego połączenia w internecie.
Protokół DNS w warstwie aplikacji (DoH, DoT, DNSSEC): Mimo służebnej roli dla warstwy sieciowej protokół ze strukturą pytań i odpowiedzi działa w warstwie siódmej na porcie 53, a rozwiązanie nazwy poprzedza niemal każde połączenie. Zagrożeniem jest zatruwanie podręcznej pamięci fałszywymi odpowiedziami. Obronę stanowią podpisy DNSSEC oraz szyfrowane transporty DoH i DoT. W WLAN fałszywy DNS i portale captive wydłużają ładowanie.
Protokół DNS (ponownie)

Protokół DNS, choć często kojarzony z warstwą sieciową ze względu na jego rolę w dostarczaniu adresów IP, jest w rzeczywistości protokołem warstwy aplikacji z własnym formatem wiadomości i logiką działania. Wiadomość DNS składa się z nagłówka oraz sekcji pytań, odpowiedzi, autorytatywnych serwerów i informacji dodatkowych, co pozwala na pakowanie wielu informacji w jednej odpowiedzi. W sieciach WLAN czas rozwiązywania nazw DNS ma bezpośredni wpływ na szybkość ładowania stron, ponieważ przeglądarka musi uzyskać adres IP serwera przed wysłaniem żądania HTTP. Opóźnienia związane z DNS w sieciach bezprzewodowych mogą być spowodowane zarówno opóźnieniami na łączu radiowym, jak i działaniem mechanizmów captive portal stosowanych w hotspotach.

Zabezpieczenie protokołu DNS jest ważnym aspektem bezpieczeństwa sieci WLAN, ponieważ tradycyjny DNS nie zapewnia żadnego mechanizmu weryfikacji autentyczności odpowiedzi. Atak polegający na zatruciu pamięci podręcznej serwera DNS może przekierowywać użytkowników na fałszywe strony bez ich wiedzy. Rozwiązaniem tego problemu jest protokół DNSSEC wprowadzający podpisy cyfrowe dla rekordów DNS. Nowoczesne protokoły, takie jak DNS over HTTPS i DNS over TLS, dodają szyfrowanie do zapytań DNS, co w publicznych sieciach WLAN zapobiega podsłuchiwaniu odwiedzanych stron internetowych.

25/58
Protokół DHCP (ponownie)
Cel slajdu: Slajd wraca do DHCP jako protokołu warstwy aplikacji z sekwencją DORA i rolą przekaźnika między VLAN-ami.

Automatyczna konfiguracja jako usługa

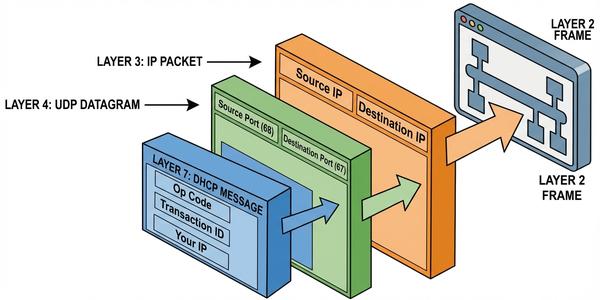
  • Podobnie jak DNS, protokół DHCP, mimo że jego celem jest konfiguracja warstwy 3 (adresu IP), sam w sobie jest protokołem działającym w modelu klient-serwer w warstwie aplikacji.
  • Definiuje on format i sekwencję wiadomości (Discover, Offer, Request, ACK), które są wymieniane między klientem a serwerem.
  • Wiadomości te są "opakowywane" w datagramy UDP (klient wysyła na port 67, serwer odpowiada na port 68), a następnie w pakiety IP i ramki.
  • To pokazuje, jak warstwy współpracują ze sobą – protokół warstwy aplikacji (DHCP) jest używany do skonfigurowania niższej warstwy (IP).
Protokół DHCP w warstwie aplikacji (sekwencja DORA, RFC 2131): Klient rozgłasza Discover, serwer oferuje Offer, klient żąda Request, a serwer potwierdza Acknowledge na portach UDP 67 i 68 z opcjami bramy, DNS i domeny. Jest kluczowy przy częstych zmianach sieci przez urządzenia mobilne. Agent relay przekazuje zapytania między VLAN-ami do centralnego serwera przy kontrolerach WLAN.
Protokół DHCP (ponownie)

Protokół Dynamic Host Configuration Protocol jest rozwinięciem starszego protokołu BOOTP i pełni funkcję automatycznego nadawania konfiguracji sieciowej urządzeniom klienckim. Pełna sekwencja DORA obejmuje cztery etapy: Discover, Offer, Request i Acknowledgement, podczas których klient i serwer uzgadniają parametry adresacji oraz dodatkowe opcje konfiguracyjne. W sieciach WLAN proces DHCP ma szczególne znaczenie, ponieważ urządzenia mobilne często zmieniają sieci i muszą szybko uzyskiwać nową konfigurację adresową. Czas potrzebny na ukończenie sekwencji DORA może być odczuwalny przez użytkownika jako opóźnienie przy pierwszym łączeniu się z siecią Wi-Fi.

Serwer DHCP może przekazywać klientom nie tylko adres IP i maskę podsieci, ale również adres bramy domyślnej, adresy serwerów DNS, domenę wyszukiwania oraz wiele innych opcji specyficznych dla danego środowiska. W rozległych sieciach WLAN z wieloma sieciami VLAN serwer DHCP musi być odpowiednio skonfigurowany do przydzielania adresów z odpowiednich pul dla poszczególnych segmentów. Mechanizm agenta przekazywania DHCP umożliwia obsługę zapytań DHCP między różnymi podsieciami, co w złożonych architekturach WLAN z kontrolerami jest niezbędne do poprawnej pracy.

26/58
Protokoły pocztowe: SMTP, POP3, IMAP
Cel slajdu: Slajd porządkuje protokoły pocztowe: wysyłkowy SMTP oraz odbiorcze POP3 i IMAP.

Jak działa e-mail?

  • Obsługa poczty elektronicznej opiera się na zestawie protokołów warstwy aplikacji.
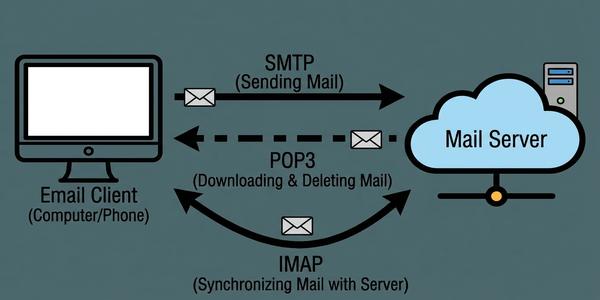
  • Do wysyłania e-maili służy SMTP (Simple Mail Transfer Protocol).
  • Kiedy klikamy "Wyślij", nasz klient poczty łączy się z serwerem SMTP (zwykle na porcie 25 lub 587) i "rozmawia" z nim, przekazując adresata, nadawcę i treść wiadomości.
  • Do odbierania poczty służą dwa protokoły.
  • Starszy, POP3 (Post Office Protocol), domyślnie pobiera wiadomości z serwera i usuwa je z niego, przechowując je lokalnie na naszym komputerze.
  • Nowszy i znacznie popularniejszy, IMAP (Internet Message Access Protocol), synchronizuje zawartość skrzynki z serwerem, przechowując wszystkie wiadomości i foldery na serwerze, co pozwala na dostęp do tej samej poczty z wielu urządzeń.
Protokoły pocztowe SMTP, POP3 i IMAP (RFC 5321 i pokrewne): Protokół SMTP z rozszerzeniem ESMTP wysyła pocztę na portach 25 i 587 z kolejkowaniem przy przerwach WLAN. Protokół POP3 pobiera listy na urządzenie i kasuje z serwera, natomiast IMAP synchronizuje foldery i flagi na serwerze dla wielu urządzeń i dziś dominuje. Nowocześnie wszystkie pracują w połączeniach szyfrowanych z uwierzytelnianiem.
Protokoły pocztowe: SMTP, POP3, IMAP

Protokół SMTP został pierwotnie zdefiniowany w dokumencie RFC 821 i od tego czasu przeszedł wiele aktualizacji, z których najważniejsza to rozszerzenie ESMTP opisane w RFC 5321. SMTP odpowiada wyłącznie za wysyłanie wiadomości od nadawcy do serwera poczty oraz za przekazywanie ich między serwerami, nie zajmuje się natomiast przechowywaniem ani prezentacją wiadomości odbiorcy. W sieciach WLAN działanie klientów pocztowych jest zależne od stabilności połączenia, a przerwy w łączności radiowej mogą powodować błędy wysyłania, które są rozwiązywane przez mechanizmy kolejek i ponawiania prób wbudowane w klienty pocztowe. Nowoczesne klienty pocztowe, takie jak Microsoft Outlook czy Mozilla Thunderbird, domyślnie używają szyfrowanych połączeń SMTP na porcie 587 z uwierzytelnianiem.

Protokół IMAP jest obecnie dominującym standardem odbierania poczty, wypierając starszy POP3 ze względu na lepszą obsługę synchronizacji między wieloma urządzeniami. W przeciwieństwie do POP3, który domyślnie pobiera wiadomości i usuwa je z serwera, IMAP przechowuje wiadomości na serwerze i synchronizuje stan folderów, flagi przeczytania i kategorię między wszystkimi urządzeniami. W sieciach WLAN używanie IMAP zwiększa komfort pracy, ponieważ umożliwia dostęp do całej skrzynki pocztowej z wielu urządzeń bez utraty informacji o stanie przetworzenia wiadomości.

27/58
Protokół FTP/FTPS/SFTP
Cel slajdu: Slajd zestawia jawny FTP z szyfrowanymi następcami FTPS i SFTP oraz trybami przez NAT.

Transfer plików

  • Do przesyłania plików między komputerami służy FTP (File Transfer Protocol).
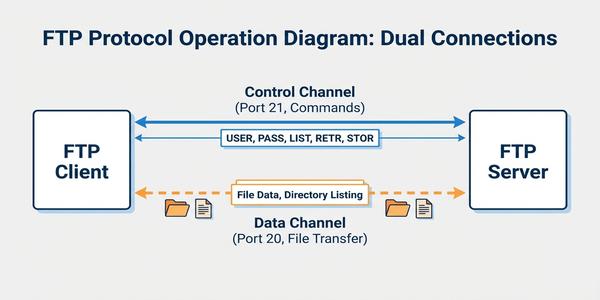
  • Jest to stary, ale wciąż używany protokół, który wykorzystuje dwa oddzielne połączenia TCP: jedno do przesyłania poleceń (kanał kontrolny, port 21) i drugie do przesyłania samych danych (kanał danych).
  • Standardowy FTP jest niezabezpieczony – hasła i dane przesyłane są jawnym tekstem.
  • Jego bezpiecznymi następcami są FTPS (FTP działający w tunelu TLS/SSL) oraz, co jest zupełnie innym protokołem, SFTP (SSH File Transfer Protocol), który jest rozszerzeniem protokołu SSH i całą komunikację realizuje w ramach jednego, bezpiecznego połączenia.
Protokoły FTP, FTPS i SFTP: Klasyczny FTP otwiera osobne połączenia kontrolne na porcie 21 i danych, przy czym tryb aktywny kłóci się z NAT, a pasywny ten problem eliminuje. Odmiana FTPS dokłada TLS, natomiast SFTP jest odrębnym protokołem na bazie SSH na porcie 22 w pełni szyfrowanym. W WLAN preferuje się SFTP, bo nie wymaga certyfikatów i bezproblemowo przechodzi przez NAT i zapory.
Protokół FTP/FTPS/SFTP

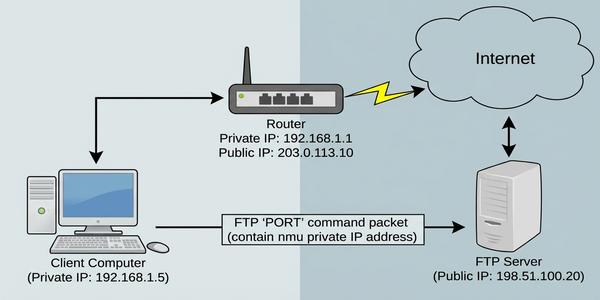
Protokół FTP w trybie aktywnym wykorzystuje osobne połączenia TCP dla kanału kontrolnego i danych, co komplikuje jego działanie przez zapory sieciowe i translację adresów NAT. W trybie aktywnym klient inicjuje połączenie kontrolne na porcie 21 serwera, a następnie informuje serwer, na którym porcie klienta serwer ma otworzyć połączenie danych. W sieciach WLAN poddanych translacji NAT tryb ten często zawodzi, ponieważ serwer nie może nawiązać połączenia z klientem o adresie prywatnym. Rozwiązaniem jest tryb pasywny FTP, w którym to serwer podaje klientowi adres i port do nawiązania połączenia danych, co eliminuje problem NAT.

Protokół SFTP jest zupełnie inną implementacją transferu plików niż FTP, działającą jako rozszerzenie protokołu SSH na domyślnym porcie dwadzieścia dwa. W odróżnieniu od FTPS, który dodaje warstwę TLS do tradycyjnego FTP, SFTP od samego początku został zaprojektowany jako bezpieczny protokół z szyfrowaniem całej komunikacji. W sieciach WLAN SFTP jest preferowanym wyborem dla transferu plików, ponieważ zapewnia ochronę przed podsłuchem bez konieczności konfiguracji dodatkowych certyfikatów, a jego działanie przez NAT i zapory sieciowe jest bezproblemowe.

28/58
Protokół SSH
Cel slajdu: Slajd przedstawia protokół SSH jako szyfrowanego następcę Telnetu do administracji i tunelowania.

Bezpieczny zdalny dostęp

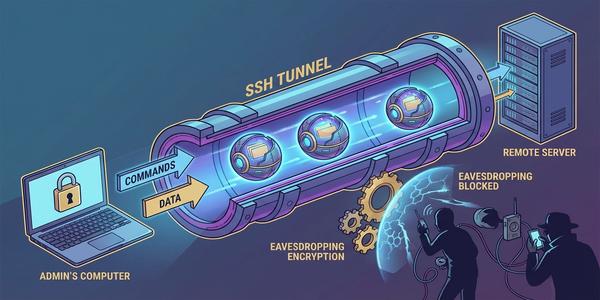
  • SSH (Secure Shell) to kluczowy protokół warstwy aplikacji, który pozwala na bezpieczny, szyfrowany zdalny dostęp do wiersza poleceń innego komputera (najczęściej serwera).
  • Zastąpił on stary i niezabezpieczony protokół Telnet.
  • Połączenie SSH, nawiązywane na porcie 22, szyfruje całą sesję, w tym proces uwierzytelniania (logowanie) oraz wszystkie przesyłane polecenia i ich wyniki.
  • Uniemożliwia to podsłuchiwanie haseł i przejęcie kontroli nad sesją.
  • SSH jest podstawowym narzędziem pracy każdego administratora systemów i sieci.
Protokół SSH (ang. Secure Shell, port TCP 22): Protokół zapewnia szyfrowaną konsolę, przekierowanie portów i transfer plików SFTP z uwierzytelnianiem kluczami asymetrycznymi zamiast haseł. Wersja druga poprawiła kryptografię i uwierzytelnianie. Umożliwia bezpieczne zarządzanie siecią WLAN nawet przez niezaufane hotspoty i jest bazą pracy każdego administratora.
Protokół SSH

Protokół SSH został opracowany jako odpowiedź na brak bezpieczeństwa w protokole Telnet i stanowi obecnie standardowy sposób zdalnego zarządzania urządzeniami sieciowymi i serwerami. Działa on w architekturze klient-serwer na porcie TCP dwadzieścia dwa i zapewnia trzy główne usługi: bezpieczną konsolę dostępową przez szyfrowany kanał, przekazywanie portów TCP oraz bezpieczny transfer plików przez SFTP. W sieciach WLAN protokół SSH jest szczególnie ceniony przez administratorów, ponieważ umożliwia bezpieczne zarządzanie infrastrukturą nawet przez niezaufane łącza bezprzewodowe, takie jak publiczne hotspoty. Mechanizm uwierzytelniania SSH opiera się na parze kluczy asymetrycznych, co eliminuje konieczność przesyłania haseł przez sieć.

SSH oferuje wiele zaawansowanych funkcji wykraczających poza prosty zdalny dostęp do konsoli, w tym tunelowanie innych protokołów przez szyfrowany kanał. Administratorzy często wykorzystują tę funkcję do bezpiecznego dostępu do wewnętrznych zasobów sieciowych z zewnątrz, na przykład do zdalnego dostępu do interfejsu administracyjnego punktu dostępowego WLAN. Protokół SSH w wersji drugiej, obecnie standardowej, wprowadził ulepszone mechanizmy uwierzytelniania i obsługę większej liczby algorytmów kryptograficznych, co zwiększa elastyczność konfiguracji i bezpieczeństwo połączeń.

29/58
Architektura Klient-Serwer
Cel slajdu: Slajd opisuje dominującą architekturę klient-serwer z bezstanowym HTTP i stanem w ciasteczkach.

Model dominujący w Internecie

  • Większość protokołów, które omówiliśmy (HTTP, FTP, SMTP), działa w architekturze klient-serwer.
  • W tym modelu mamy do czynienia z dwoma typami oprogramowania.
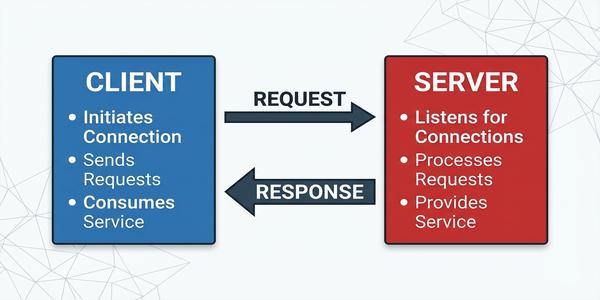
  • Serwer to program, który działa pasywnie, nasłuchując na znanym porcie na przychodzące żądania.
  • Jest on dostawcą usługi lub zasobu.
  • Klient to program, który aktywnie inicjuje komunikację, wysyłając żądanie do serwera, a następnie oczekuje na odpowiedź.
  • Nasza przeglądarka jest klientem, a serwer, na którym znajduje się strona WWW, jest serwerem.
  • Ta asymetryczna relacja jest podstawą działania większości usług internetowych.
Architektura klient-serwer: Pasywny serwer nasłuchuje w pętli, a aktywny klient inicjuje żądania protokołów pokroju HTTP, FTP i SMTP, przy czym serwer obsługuje wielu klientów wątkami albo asynchronicznie. Protokół HTTP jest bezstanowy, a stan koszyka i logowania utrzymują ciasteczka i sesje. Klienci mobilni muszą obsługiwać utratę łączności i ponawianie żądań przy roamingu.
Architektura Klient-Serwer

Architektura klient-serwer jest dominującym modelem komunikacji w Internecie, w którym serwer działa jako pasywny dostawca usług oczekujący na żądania, a klient aktywnie inicjuje komunikację. Serwer musi być w stanie obsługiwać wielu klientów jednocześnie, co realizuje poprzez mechanizmy wielowątkowości lub asynchronicznego przetwarzania żądań. W sieciach WLAN aplikacje klienckie działające na urządzeniach mobilnych muszą być zaprojektowane z uwzględnieniem możliwości chwilowej utraty łączności i zmian adresu IP związanych z roamingiem pomiędzy punktami dostępowymi. Nowoczesne frameworki programistyczne dostarczają gotowych mechanizmów obsługi błędów sieciowych i automatycznego ponawiania żądań.

W architekturze klient-serwer ważnym pojęciem jest stanowość lub bezstanowość protokołu. Protokół HTTP jest domyślnie bezstanowy, co oznacza, że każde żądanie jest niezależne i serwer nie przechowuje informacji o poprzednich żądaniach od tego samego klienta. Mechanizmy takie jak ciasteczka i sesje serwerowe dodają stanowość na poziomie aplikacji, umożliwiając utrzymanie koszyka zakupowego czy stanu logowania w serwisach internetowych. W sieciach WLAN zarządzanie sesjami w aplikacjach klient-serwer wymaga uwzględnienia dłuższych czasów odpowiedzi i możliwości przerywania połączenia.

30/58
Architektura Peer-to-Peer (P2P)
Cel slajdu: Slajd przedstawia architekturę peer-to-peer bez centrum oraz jej wcielenie w Wi-Fi Direct.

Wszyscy są równi

  • Alternatywą dla modelu klient-serwer jest architektura Peer-to-Peer (P2P).
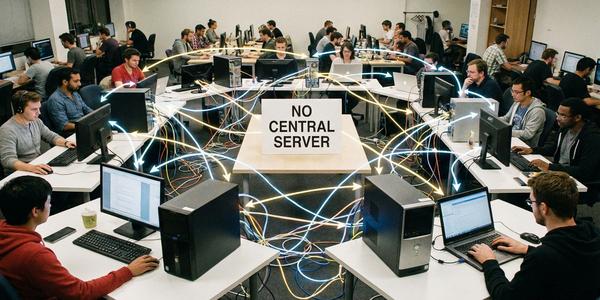
  • W sieci P2P nie ma centralnego serwera.
  • Każdy uczestnik sieci (zwany "peerem" lub węzłem) jest równy i może pełnić jednocześnie rolę zarówno klienta, jak i serwera – pobierać dane od innych i jednocześnie udostępniać je innym.
  • Ten zdecentralizowany model jest bardzo odporny na awarie (nie ma jednego punktu, który może zawieść) i doskonale skalowalny.
  • Im więcej użytkowników dołącza do sieci, tym większa jest jej łączna przepustowość.
  • Architektura P2P jest wykorzystywana m.in. w systemach wymiany plików (np. BitTorrent), niektórych komunikatorach i kryptowalutach.
Architektura peer-to-peer P2P (BitTorrent, Wi-Fi Direct): Węzły są jednocześnie klientami i serwerami, więc odporność i pojemność rosną z liczbą uczestników, a typowym przykładem jest BitTorrent dzielący plik na fragmenty. W WLAN odpowiednikiem jest Wi-Fi Direct do druku, plików i gier bez punktu dostępowego. Ograniczeniami są asymetria radia i blokowanie P2P w sieciach publicznych.
Architektura Peer-to-Peer (P2P)

Architektura P2P różni się zasadniczo od modelu klient-serwer brakiem centralnego punktu kontroli i równorzędnością wszystkich uczestników sieci. W czystej implementacji P2P każdy węzeł pełni jednocześnie funkcje klienta i serwera, co eliminuje problem pojedynczego punktu awarii charakterystyczny dla architektur scentralizowanych. W sieciach WLAN architektura P2P jest realizowana przez standard Wi-Fi Direct, który umożliwia bezpośrednią komunikację między urządzeniami bez potrzeby korzystania z punktu dostępowego. Rozwiązanie to jest wykorzystywane w drukowaniu bezprzewodowym, udostępnianiu plików między smartfonami oraz w niektórych grach multiplayer.

System BitTorrent, będący najpopularniejszym przykładem architektury P2P, dzieli pliki na małe fragmenty i umożliwia ich pobieranie równocześnie od wielu użytkowników. W sieciach WLAN wydajność P2P może być ograniczona przez asymetrię łącza radiowego, które często oferuje różne prędkości w górę i w dół. Kryptowaluty, takie jak Bitcoin, wykorzystują architekturę P2P do utrzymania rozproszonej księgi transakcji bez centralnego autorytetu, co wymaga stałej łączności sieciowej uczestników. W publicznych sieciach WLAN ruch P2P jest często ograniczany lub blokowany przez administratorów ze względu na duże zużycie pasma.

31/58
API (Application Programming Interface)
Cel slajdu: Slajd definiuje interfejs API ze stylem REST i alternatywą GraphQL jako sposób oszczędzania pasma.

Jak aplikacje ze sobą rozmawiają?

  • W nowoczesnym internecie aplikacje i usługi nieustannie komunikują się ze sobą, wymieniając dane.
  • Służą do tego API (Application Programming Interface).
  • API to formalny zbiór reguł i definicji, który określa, w jaki sposób jedna aplikacja może żądać usług lub danych od drugiej.
  • Najpopularniejszym stylem architektonicznym dla API webowych jest REST (Representational State Transfer).
  • API typu REST zazwyczaj komunikuje się za pomocą protokołu HTTP, a dane wymienia w formacie JSON.
  • Na przykład, aplikacja pogodowa na Twoim telefonie nie ma w sobie danych o pogodzie.
  • Używa ona API, aby wysłać żądanie HTTP do serwera pogodowego (`GET /pogoda?miasto=Warszawa`), który w odpowiedzi odsyła dane w formacie JSON.
Interfejs API i styl REST (ang. Application Programming Interface, Representational State Transfer): Interfejs to formalne reguły wymiany danych między aplikacjami, a styl REST narzuca bezstanowość, adresowanie zasobów URI oraz czasowniki GET, POST, PUT i DELETE z danymi w JSON. Przykładowe zapytanie o pogodę zwraca lekki dokument zamiast strony HTML. Precyzyjniejszy GraphQL pobiera tylko żądane pola, co oszczędza pasmo WLAN.
API (Application Programming Interface)

Interfejsy programistyczne aplikacji stanowią fundament współczesnej integracji systemów, umożliwiając różnorodnym aplikacjom wymianę danych i usług w ustandaryzowany sposób. API webowe najczęściej korzystają z protokołu HTTP i formatu JSON do komunikacji, co zapewnia uniwersalność i łatwość implementacji niezależnie od używanego języka programowania czy platformy sprzętowej. W sieciach WLAN wydajność API ma bezpośrednie przełożenie na szybkość działania aplikacji mobilnych, ponieważ każde wywołanie API wiąże się z transmisją danych przez łącze radiowe. Projektanci API powinni uwzględniać specyfikę sieci bezprzewodowych, minimalizując liczbę żądań i rozmiar przesyłanych danych.

Styl architektoniczny REST opiera się na kilku fundamentalnych zasadach, w tym bezstanowości, identyfikacji zasobów poprzez URI oraz użyciu standardowych metod HTTP, takich jak GET, POST, PUT i DELETE. RESTful API są szczególnie popularne w aplikacjach mobilnych działających w sieciach WLAN ze względu na swoją prostotę i efektywność. Alternatywą dla REST jest GraphQL, który umożliwia klientom precyzyjne określenie, jakie dane chcą pobrać, co zmniejsza ilość danych przesyłanych przez sieć. W sieciach WLAN o ograniczonej przepustowości takie rozwiązania mogą znacznie poprawić wydajność aplikacji.

32/58
Model OSI a Model TCP/IP
Cel slajdu: Slajd zestawia siedmiowarstwowy model OSI z czterowarstwowym modelem TCP/IP używanym w Internecie.

Teoria kontra praktyka

  • Przez cały kurs posługiwaliśmy się 7-warstwowym modelem OSI.
  • Jest on doskonałym modelem teoretycznym, który precyzyjnie rozdziela funkcje sieciowe.
  • W praktyce jednak, świat Internetu jest zbudowany w oparciu o prostszy, 4-warstwowy model TCP/IP (zwany też modelem DoD).
  • W tym modelu funkcje warstw Aplikacji, Prezentacji i Sesji z modelu OSI są połączone w jedną, wspólną warstwę Aplikacji.
  • Podobnie, warstwy Łącza Danych i Fizyczna są połączone w warstwę Dostępu do Sieci.
  • Model TCP/IP jest modelem praktycznym, który opisuje, jak faktycznie zaimplementowano protokoły internetowe.
Modele OSI a TCP/IP (7 warstw vs 4 warstwy): Model OSI precyzyjnie dzieli komunikację na siedem warstw jako narzędzie teorii i diagnostyki, natomiast praktyczny model TCP/IP grupuje warstwy sesji, prezentacji i aplikacji w jedną oraz warstwy fizyczną i łącza w dostęp do sieci. WLAN pracuje w modelu TCP/IP, lecz standard 802.11 i analiza kapsułkowania wymagają pojęć OSI. Obu modeli uczy się równolegle jako uzupełniających.
Model OSI a Model TCP/IP

Różnice między modelem OSI a modelem TCP/IP wynikają z odmiennego podejścia do projektowania architektury sieciowej. Model OSI został opracowany jako uniwersalny standard teoretyczny przez Międzynarodową Organizację Normalizacyjną, podczas gdy model TCP/IP powstał w praktyce w ramach projektu ARPANET i był stopniowo rozwijany przez społeczność internetową. TCP/IP łączy warstwy aplikacji, prezentacji i sesji w jedną warstwę aplikacji, ponieważ w praktyce rozdzielenie tych funkcji okazało się niepraktyczne w implementacjach. Podobnie warstwy łącza danych i fizyczna są połączone w warstwę dostępu do sieci, co odzwierciedla sposób działania rzeczywistych stosów protokołów.

W sieciach WLAN najczęściej operuje się na modelu TCP/IP ze względu na jego praktyczne zastosowanie w konfiguracji urządzeń i rozwiązywaniu problemów. Mimo to znajomość modelu OSI jest niezbędna do zrozumienia relacji między protokołami i warstwami, szczególnie w kontekście enkapsulacji danych i rozwiązywania problemów sieciowych. Model OSI wywierał duży wpływ na rozwój standardów sieciowych, w tym IEEE 802.11 dla sieci bezprzewodowych, których dokumentacja często odwołuje się do koncepcji warstw OSI. W edukacji sieciowej oba modele są nauczane równolegle, ponieważ uzupełniają się wzajemnie.

33/58
NTP (Network Time Protocol)
Cel slajdu: Slajd przedstawia protokół NTP jako hierarchiczną dystrybucję czasu dokładną do milisekund.

Synchronizacja czasu w sieci

  • Czy zastanawiali się Państwo, skąd komputery i urządzenia sieciowe "wiedzą", która jest godzina?
  • Za synchronizację zegarów w sieci odpowiada protokół warstwy aplikacji NTP (Network Time Protocol).
  • Urządzenia (klienci NTP) okresowo wysyłają zapytania do serwerów NTP (działających na porcie UDP 123).
  • Serwery te to komputery o bardzo wysokiej precyzji, często zsynchronizowane z zegarami atomowymi.
  • Protokół NTP jest zaprojektowany tak, aby uwzględniać opóźnienia sieciowe i pozwalać na synchronizację zegarów z dokładnością do milisekund.
  • Precyzyjny czas jest absolutnie kluczowy w sieciach, m.in. do poprawnego działania logów systemowych, mechanizmów uwierzytelniania (np. Kerberos) i szyfrowania.
Protokół NTP (ang. Network Time Protocol, UDP 123): Hierarchia warstw stratum prowadzi od zegarów atomowych i GPS przez serwery pierwszej i dalszych warstw, z uwzględnieniem opóźnień i odrzucaniem anomalii radia WLAN. Dokładność rzędu milisekund wystarcza dla logów, protokołu Kerberos i korelacji incydentów. Bardziej wymagający protokół PTP osiąga mikrosekundy większym kosztem złożoności.
NTP (Network Time Protocol)

Protokół NTP został opracowany przez grupę inżynierów pod kierunkiem Dave Millsa i pozostaje jednym z najstarszych wciąż używanych protokołów internetowych, pierwsze wersje pochodzą z lat osiemdziesiątych dwudziestego wieku. NTP działa na porcie UDP 123 i wykorzystuje hierarchiczną strukturę warstw, w której serwery warstwy zerowej są synchronizowane bezpośrednio z atomowymi zegarami wzorcowymi lub odbiornikami GPS. Każda kolejna warstwa wprowadza niewielkie opóźnienie i niedokładność, ale w typowej sieci WLAN dokładność synchronizacji z serwerem warstwy drugiej lub trzeciej wynosi kilka milisekund, co jest w pełni wystarczające dla większości zastosowań.

W sieciach WLAN synchronizacja czasu za pomocą NTP napotyka na dodatkowe wyzwania związane ze zmiennymi opóźnieniami na łączu radiowym. Algorytmy NTP są jednak zaprojektowane do filtrowania próbek o nietypowych opóźnieniach i wybierania najbardziej wiarygodnych źródeł czasu. Precyzyjny czas jest kluczowy dla poprawności logów zdarzeń w infrastrukturze WLAN, ponieważ umożliwia korelację zdarzeń z wielu urządzeń, co jest niezbędne przy analizie incydentów bezpieczeństwa i problemów wydajnościowych. W wymagających środowiskach stosuje się protokół PTP, który oferuje dokładność rzędu mikrosekund kosztem większej złożoności konfiguracji.

34/58
SNMP (Simple Network Management Protocol)
Cel slajdu: Slajd opisuje protokół SNMP z bazą MIB jako podstawę monitoringu routerów i punktów dostępowych.

Zarządzanie i monitorowanie sieci

  • SNMP to protokół warstwy aplikacji służący do zarządzania i monitorowania urządzeń sieciowych, takich jak routery, przełączniki czy punkty dostępowe.
  • Działa w modelu menedżer-agent.
  • Na każdym zarządzanym urządzeniu działa agent SNMP, który zbiera statystyki (np. obciążenie procesora, ruch na interfejsach) i przechowuje je w bazie MIB (Management Information Base).
  • Menedżer SNMP (stacja zarządzająca) może odpytywać agentów o te informacje (SNMP GET), a także zmieniać ich konfigurację (SNMP SET).
  • Agenci mogą również samoczynnie wysyłać do menedżera alerty (Traps) w przypadku wystąpienia ważnych zdarzeń, np. awarii interfejsu.
Protokół SNMP (ang. Simple Network Management Protocol, baza MIB): Menedżer odpytuje agentów w urządzeniach o obiekty bazy MIB operacjami odczytu GET i zapisu SET, a agent spontanicznie wysyła pułapki Trap o zdarzeniach pokroju padnięcia interfejsu. Wersja trzecia dodaje uwierzytelnianie i szyfrowanie, których brak w starszych wspólnotach community. Narzędzia pokroju Zabbix zbierają obciążenie, klientów i siłę sygnału punktów dostępowych.
SNMP (Simple Network Management Protocol)

Protokół SNMP w wersji trzeciej, będącej aktualnym standardem, wprowadza zaawansowane mechanizmy bezpieczeństwa, w tym uwierzytelnianie użytkowników i szyfrowanie transmisji. SNMPv1 i SNMPv2c używały tzw. community strings (ciągów społeczności) przesyłanych w postaci jawnego tekstu, co stanowiło poważne zagrożenie bezpieczeństwa. Baza MIB jest hierarchiczną strukturą danych, która definiuje zarządzane obiekty w standardzie ASN.1, a każdy obiekt jest jednoznacznie identyfikowany przez identyfikator OID. W sieciach WLAN SNMP jest używany do monitorowania obciążenia punktów dostępowych, liczby obsługiwanych klientów, poziomu sygnału oraz wielu innych parametrów istotnych dla utrzymania infrastruktury.

Systemy monitorujące takie jak Nagios, Zabbix czy PRTG wykorzystują SNMP do ciągłego zbierania danych z urządzeń sieciowych i generowania alertów w przypadku przekroczenia progów ostrzegawczych. W rozległych instalacjach WLAN z dziesiątkami lub setkami punktów dostępowych centralne monitorowanie za pomocą SNMP jest niezbędne do utrzymania kontroli nad stanem infrastruktury. Agent SNMP na punkcie dostępowym może być skonfigurowany do wysyłania niepotwierdzonych pułapek do stacji zarządzającej w przypadku wystąpienia zdarzeń krytycznych, takich jak awaria interfejsu sieciowego lub nieautoryzowana próba dostępu.

35/58
Syslog
Cel slajdu: Slajd przedstawia dziennik systemowy jako centralny zbiór logów z urządzeń sieciowych.

Centralne zbieranie logów

  • Syslog to standardowy protokół służący do centralnego gromadzenia logów (dzienników zdarzeń) z różnych urządzeń i systemów w sieci.
  • Każde urządzenie (router, firewall, serwer) może być skonfigurowane tak, aby wysyłało swoje komunikaty logów w czasie rzeczywistym do centralnego serwera Syslog.
  • Komunikaty są wysyłane jako proste datagramy UDP na port 514.
  • Zawierają one informację o czasie zdarzenia, jego ważności (od "debug" po "emergency") oraz samą treść komunikatu.
  • Centralne zbieranie logów jest kluczowe dla monitorowania stanu sieci, diagnozowania problemów i analizy incydentów bezpieczeństwa.
Dziennik Syslog (RFC 5424, UDP 514): Urządzenia wysyłają komunikaty z priorytetem złożonym z obiektu i ważności od debugowania po awarię do centralnego serwera w czasie rzeczywistym. Koncentracja logów z routerów, zapór i kontrolerów ułatwia diagnostykę uwierzytelniania 802.1X, DHCP i bezpieczeństwa WLAN. Stosy pokroju ELK indeksują, wizualizują i wykrywają trendy w milionach zdarzeń.
Syslog

Protokół Syslog został pierwotnie zaimplementowany w systemie Sendmail i szybko stał się standardem gromadzenia logów w systemach uniksowych i linuksowych. Standard RFC 5424 formalnie zdefiniował format wiadomości Syslog, wprowadzając ustrukturyzowane dane i lepszą obsługę kodowania znaków. Każda wiadomość Syslog zawiera priorytet obliczony na podstawie identyfikatora obiektu i ważności zdarzenia, co pozwala na filtrowanie i odpowiednie kierowanie logów do różnych miejsc docelowych. W sieciach WLAN centralny serwer Syslog gromadzi logi ze wszystkich punktów dostępowych, kontrolerów i przełączników, co umożliwia kompleksowy wgląd w stan infrastruktury.

W praktyce administracyjnej Syslog jest niezastąpiony przy diagnozowaniu problemów związanych z autoryzacją klientów WLAN, błędami konfiguracji i incydentami bezpieczeństwa. Analiza logów Syslog może ujawnić próby nieautoryzowanego dostępu, błędy uwierzytelniania 802.1x oraz problemy z przydziałem adresów DHCP. Rozwiązania takie jak ELK Stack umożliwiają centralizację, indeksację i wizualizację logów Syslog z całej infrastruktury WLAN, co znacząco przyspiesza proces diagnostyczny i umożliwia wykrywanie trendów wskazujących na zbliżające się problemy.

36/58
Telnet: Przestroga z przeszłości
Cel slajdu: Slajd przestrzega przed jawnym Telnetem jako podręcznikowym przykładem protokołu do wycofania.

Niezabezpieczony zdalny dostęp

  • Przed erą SSH, standardowym protokołem do zdalnego zarządzania urządzeniami był Telnet.
  • Działa on na porcie TCP 23 i pozwala na uzyskanie dostępu do wiersza poleceń zdalnego systemu.
  • Jego fundamentalną i dyskwalifikującą dziś wadą jest całkowity brak szyfrowania.
  • Wszystkie dane, w tym login, hasło oraz cała sesja, są przesyłane przez sieć jako jawny tekst.
  • Oznacza to, że każdy, kto jest w stanie podsłuchać ruch w sieci (co w Wi-Fi jest trywialne), może przechwycić poświadczenia i uzyskać pełny dostęp do zarządzanego urządzenia.
  • Z tego powodu Telnet nie powinien być nigdy używany w niezaufanych sieciach.
Protokół Telnet (TCP 23, RFC 854): Zdalna konsola przesyła login, hasło i całą sesję jawnym tekstem, co w WLAN sprowadza podsłuch do uruchomienia analizatora. Jest dziś domyślnie wyłączony i zastąpiony przez SSH. Dopuszcza się go jedynie w laboratoriach, starszej automatyce przemysłowej i ręcznych testach protokołów tekstowych pokroju SMTP i HTTP.
Telnet: Przestroga z przeszłości

Protokół Telnet został zdefiniowany w dokumencie RFC 854 i przez wiele lat stanowił podstawowe narzędzie do interaktywnego dostępu do systemów uniksowych i urządzeń sieciowych. W czasie jego powstania bezpieczeństwo sieci nie było priorytetem, a zakładano, że medium transmisyjne jest fizycznie chronione przed dostępem osób nieupoważnionych. W środowisku WLAN, gdzie sygnał radiowy rozchodzi się poza granice fizyczne budynku i może być przechwycony przez każdego w zasięgu, używanie Telnetu do zarządzania urządzeniami jest skrajnie nieodpowiedzialne. Narzędzia do przechwytywania pakietów, takie jak Wireshark, mogą łatwo wydobyć login i hasło z przechwyconej sesji Telnet.

Mimo swoich wad Telnet pozostaje użyteczny w niektórych scenariuszach, na przykład w zamkniętych sieciach laboratoryjnych, w starszych urządzeniach przemysłowych lub jako narzędzie do ręcznego testowania protokołów tekstowych, takich jak SMTP czy HTTP. Współczesne systemy operacyjne nie instalują domyślnie klienta Telnet, a na serwerach usługa Telnet jest zazwyczaj wyłączona. Wszystkie nowe wdrożenia powinny korzystać z protokołu SSH jako bezpiecznej alternatywy, zapewniającej szyfrowanie całej sesji i uwierzytelnianie za pomocą kluczy publicznych.

37/58
RTP/RTCP: Strumieniowanie multimediów
Cel slajdu: Slajd opisuje protokoły RTP i RTCP jako transport głosu i obrazu z raportowaniem jakości.

Transport dla danych czasu rzeczywistego

  • Aplikacje takie jak VoIP czy streaming wideo używają UDP do transportu danych, ale sam UDP nie dostarcza żadnych informacji o synchronizacji czasowej.
  • Tę rolę pełni RTP (Real-time Transport Protocol), protokół warstwy aplikacji, który działa "na wierzchu" UDP.
  • Każdy pakiet RTP, oprócz danych (np. próbki dźwięku), zawiera w nagłówku znacznik czasu (timestamp) oraz numer sekwencyjny.
  • Pozwala to odbiorcy na odtworzenie multimediów w poprawnej kolejności i z odpowiednią synchronizacją, a także na kompensację zjawiska "jitter" (zmienności opóźnień).
  • RTP często towarzyszy protokół RTCP (RTP Control Protocol), który służy do przesyłania statystyk o jakości transmisji.
Protokoły RTP i RTCP (ang. Real-time Transport Protocol, RFC 3550): Protokół RTP na UDP znacznikuje pakiety czasem i numerami do uporządkowania, synchronizacji i kompensacji wahania opóźnienia. Protokół RTCP raportuje straty, opóźnienia i wahania, umożliwiając adaptację kodeka i przepływności. Opóźnienia WLAN słychać jako przerwy i zniekształcenia, dlatego ruch wymaga priorytetyzacji, a przeglądarkowy WebRTC buduje na tych samych zasadach.
RTP/RTCP: Strumieniowanie multimediów

Protokół RTP został zaprojektowany do przenoszenia strumieni danych czasu rzeczywistego, takich jak audio i wideo, przez sieci IP z zachowaniem wymaganej synchronizacji czasowej. Każdy pakiet RTP zawiera nagłówek z polem znacznika czasu oraz numerem sekwencyjnym, co umożliwia odtworzenie mediów po stronie odbiorcy z zachowaniem właściwej kolejności i tempa. W sieciach WLAN duże opóźnienia mogą powodować opóźnione dotarcie pakietów RTP, co skutkuje przerwami w odtwarzaniu lub zniekształceniami dźwięku. Kodeki używane w systemach VoIP mają różne wymagania co do przepustowości i tolerancji na utratę pakietów, co wpływa na jakość rozmowy w sieciach bezprzewodowych.

Protokół RTCP działa równolegle z RTP i służy do przesyłania informacji zwrotnych o jakości transmisji, takich jak liczba utraconych pakietów, opóźnienie i zmienność opóźnień. Na podstawie tych danych nadawca może dostosować parametry kodowania, na przykład obniżyć przepustowość strumienia przy wykryciu przeciążenia sieci. W standardzie WebRTC, który umożliwia komunikację w czasie rzeczywistym w przeglądarce, RTP i RTCP są wykorzystywane do przesyłania strumieni audio i wideo między klientami, co w sieciach WLAN wymaga starannego zarządzania pasmem i priorytetyzacją ruchu.

38/58
SIP (Session Initiation Protocol)
Cel slajdu: Slajd przedstawia protokół SIP jako sygnalizację rozmów głosowych z problemami przy NAT.

Nawiązywanie rozmów VoIP

  • Jak telefon VoIP wie, jak "zadzwonić" na inny numer?
  • Do sygnalizacji, czyli nawiązywania, modyfikowania i kończenia sesji multimedialnych (np. rozmów głosowych), służy protokół warstwy aplikacji SIP (Session Initiation Protocol).
  • Działa on w modelu tekstowym, podobnym do HTTP.
  • Kiedy dzwonimy, nasz telefon wysyła do serwera SIP (tzw. centrali PBX) wiadomość `INVITE`, zapraszając drugiego użytkownika do rozmowy.
  • Serwer lokalizuje drugiego użytkownika i przekazuje mu zaproszenie.
  • Po wymianie kilku wiadomości i zaakceptowaniu połączenia, SIP "schodzi z drogi", a właściwa transmisja głosu odbywa się już bezpośrednio między telefonami za pomocą RTP/UDP.
Protokół SIP (ang. Session Initiation Protocol, RFC 3261): Sygnalizacja o składni podobnej do HTTP zestawia, modyfikuje i kończy sesje komunikatami INVITE, ACK, BYE i REGISTER, po czym głos płynie bezpośrednio strumieniem RTP. Adresy w treści komunikatów kłócą się z NAT, co rozwiązują protokoły STUN i TURN. W WLAN zaleca się szyfrowane odmiany SIP/TLS z SRTP i odpowiednie reguły zapory.
SIP (Session Initiation Protocol)

Protokół SIP, zdefiniowany w dokumencie RFC 3261, jest protokołem sygnalizacyjnym służącym do nawiązywania, modyfikowania i kończenia sesji multimedialnych, w tym rozmów głosowych, wideokonferencji i przesyłania wiadomości błyskawicznych. SIP wykorzystuje model tekstowy podobny do HTTP, co ułatwia jego implementację i debugowanie. Podstawową jednostką komunikacji SIP jest żądanie, takie jak INVITE, ACK, BYE czy REGISTER, oraz odpowiedź z kodem statusu. W sieciach WLAN działanie SIP może być zakłócone przez translację NAT, ponieważ protokół ten przenosi adresy IP w treści wiadomości, a nie tylko w nagłówkach pakietów.

Rozwiązaniem problemów SIP z NAT jest stosowanie protokołu STUN do wykrywania publicznego adresu IP oraz protokołu TURN do pośredniczenia w transmisji, gdy bezpośrednia komunikacja jest niemożliwa. Serwery SIP pełnią funkcję rejestracji użytkowników, lokalizacji i przekazywania połączeń, działając jako centrala telefoniczna w architekturze VoIP. W publicznych sieciach WLAN ruch SIP jest często blokowany lub ograniczany przez zapory ogniowe, co motywuje administratorów do stosowania szyfrowania SIP z wykorzystaniem TLS oraz SRTP do zabezpieczenia strumieni multimedialnych.

39/58
SMB/CIFS: Udostępnianie plików w Windows
Cel slajdu: Slajd omawia protokół SMB jako sieciowy system plików Windows wrażliwy na opóźnienia radia.

Dostęp do folderów sieciowych

  • Protokół SMB (Server Message Block), znany też pod starszą nazwą CIFS (Common Internet File System), to protokół warstwy aplikacji dominujący w sieciach opartych na systemie Windows.
  • Służy on do udostępniania plików, drukarek i innych zasobów w sieci lokalnej.
  • Kiedy w Eksploratorze Windows otwieramy folder sieciowy, nasz komputer używa protokołu SMB (zazwyczaj przez TCP na porcie 445), aby komunikować się z serwerem plików, listować zawartość katalogów, odczytywać i zapisywać pliki.
  • SMB implementuje również własne mechanizmy uwierzytelniania i autoryzacji, kontrolując, kto i jaki ma dostęp do udostępnionych zasobów.
Protokół SMB/CIFS (ang. Server Message Block, TCP 445): Dominujący w Windows protokół udostępnia foldery i drukarki w sieci lokalnej z własnym uwierzytelnianiem, a wersja trzecia dodaje szyfrowanie, wielokanałowość i odporność na zaniki. Opóźnienia i roaming WLAN spowalniają pracę z dużymi plikami i aplikacjami z udziałów. Trend odchodzi ku chmurze, a doraźnie pomaga szybki roaming 802.11r i dobre pokrycie.
SMB/CIFS: Udostępnianie plików w Windows

Protokół SMB działa w modelu klient-serwer i umożliwia aplikacjom odczytywanie, zapisywanie i zarządzanie plikami na zdalnym serwerze tak, jakby były one przechowywane lokalnie. Wersja SMB 3.0, wprowadzona w systemie Windows Server 2012, dodała obsługę szyfrowania end-to-end, wielokanałowość i odporność na awarie, co zwiększyło bezpieczeństwo i wydajność w sieciach WLAN. W sieciach bezprzewodowych działanie SMB może być spowolnione przez zwiększone opóźnienia i możliwość zrywania połączeń, co szczególnie dotkliwie wpływa na otwieranie dużych plików lub uruchamianie aplikacji bezpośrednio z udziałów sieciowych.

Nowoczesne implementacje SMB w systemach Windows wspierają mechanizmy optymalizujące działanie w sieciach o dużej zmienności opóźnień, takie jak buforowanie po stronie klienta i kompresja danych. W sieciach WLAN z roamingiem pomiędzy punktami dostępowymi sesje SMB mogą być tymczasowo przerywane, co powoduje błędy dostępu do plików. Rozwiązaniem jest stosowanie mechanizmów szybkiego roamingu standardu 802.11r oraz zapewnienie odpowiedniego pokrycia sygnałem na całym obszarze biura. Współcześnie zamiast bezpośrednich udziałów SMB przez WLAN coraz częściej korzysta się z rozwiązań chmurowych.

40/58
NFS (Network File System)
Cel slajdu: Slajd przedstawia protokół NFS jako uniksowy odpowiednik współdzielenia plików przez RPC.

Udostępnianie plików w świecie Linux/Unix

  • Odpowiednikiem SMB w świecie systemów uniksowych i linuksowych jest NFS (Network File System).
  • Jest to również protokół warstwy aplikacji, który pozwala na "zamontowanie" zdalnego systemu plików na lokalnym komputerze, tak że staje się on widoczny jako zwykły katalog.
  • Z perspektywy użytkownika i aplikacji, operacje na plikach w zamontowanym katalogu NFS są przezroczyste i wyglądają tak samo jak operacje na plikach lokalnych.
  • System operacyjny w tle tłumaczy te operacje na zdalne wywołania procedur (RPC) i wysyła je przez sieć do serwera NFS.
Protokół NFS (ang. Network File System, v4 w RFC 7530 i 8881): Zdalny system plików montowany jak lokalny katalog umożliwia transparentne operacje poprzez zdalne wywołania procedur RPC. Wersja czwarta dodaje szyfrowanie, lepsze uwierzytelnianie i wydajność. Bez szyfrowania protokół jest wrażliwy na podsłuch, więc zaleca się tunel VPN. W WLAN działa wolniej niż przewodowo, lecz pozostaje popularny w firmach i na uczelniach.
NFS (Network File System)

Protokół NFS został opracowany przez Sun Microsystems w latach osiemdziesiątych dwudziestego wieku i pozostaje podstawowym mechanizmem udostępniania plików w środowiskach uniksowych i linuksowych. Wersja czwarta protokołu NFS, zdefiniowana w dokumentach RFC 7530 i RFC 8881, wprowadziła obsługę szyfrowania, silniejszego uwierzytelniania oraz lepszej wydajności w sieciach o dużych opóźnieniach. NFS działa na zasadzie zdalnych wywołań procedur, gdzie operacje na plikach są tłumaczone na zapytania RPC i wysyłane przez sieć do serwera. W sieciach WLAN wydajność NFS może być znacznie niższa niż w sieciach przewodowych ze względu na opóźnienia i utratę pakietów charakterystyczną dla łącza radiowego.

Protokół NFS często korzysta z dodatkowych protokołów pomocniczych, takich jak Portmapper do mapowania usług RPC na numery portów oraz NIS do centralnego zarządzania tożsamościami użytkowników. Bezpieczeństwo NFS w sieciach WLAN wymaga szczególnej uwagi, ponieważ standardowa wersja protokołu nie szyfruje transmisji. Zaleca się stosowanie NFS przez tunel VPN lub korzystanie z rozszerzeń zabezpieczeń dostępnych w wersji czwartej. Mimo rosnącej popularności rozwiązań chmurowych NFS pozostaje szeroko stosowany w środowiskach korporacyjnych i akademickich do współdzielenia danych między serwerami i stacjami roboczymi.

41/58
Wykrywanie Usług: mDNS, SSDP
Cel slajdu: Slajd opisuje protokoły wykrywania usług mDNS i SSDP jako automatyczne ogłaszanie drukarek i mediów.

Jak urządzenia znajdują się w sieci lokalnej?

  • W nowoczesnych sieciach domowych urządzenia potrafią automatycznie wykrywać siebie nawzajem bez żadnej konfiguracji (konfiguracja "zero-touch").
  • Drukarka pojawia się na liście dostępnych drukarek, a telewizor na liście urządzeń do strumieniowania.
  • Odpowiadają za to protokoły wykrywania usług warstwy aplikacji, takie jak mDNS (multicast DNS), używany przez Apple (Bonjour) i wiele innych systemów.
  • Urządzenie rozgłasza w sieci lokalnej (przez multicast na adres 224.0.0.251) swoje nazwy i usługi.
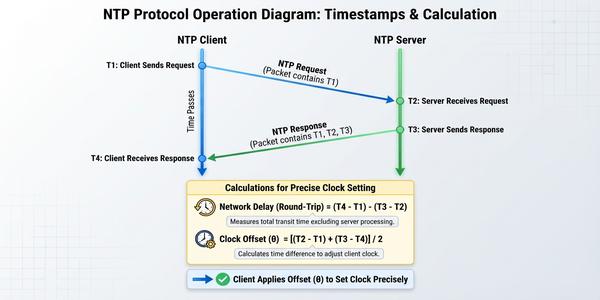
  • Innym popularnym protokołem jest SSDP (Simple Service Discovery Protocol), będący częścią standardu UPnP, używany do wykrywania np. serwerów mediów.
Wykrywanie usług mDNS i SSDP (Bonjour, UPnP): Protokół mDNS rozgłasza usługi w grupie 224.0.0.251 z domeną local bez serwera DNS, natomiast SSDP ogłasza urządzenia UPnP w grupie 239.255.255.250 na porcie 1900. Dzięki nim drukarka i telewizor same pojawiają się w systemach pokroju AirDrop i Chromecast. W gęstych WLAN nadmiar ruchu grupowego obniża wydajność, więc korporacyjnie się go ogranicza.
Wykrywanie Usług: mDNS, SSDP

Protokół mDNS działa na zasadzie rozgłaszania zapytań DNS w sieci lokalnej za pomocą transmisji multicast, bez potrzeby konfiguracji dedykowanego serwera DNS. Urządzenia odpowiadające na zapytania mDNS rejestrują swoje nazwy w domenie .local i odpowiadają na zapytania skierowane do tych nazw. W sieciach WLAN mDNS jest szczególnie użyteczny w środowiskach domowych i małych biurach, gdzie umożliwia automatyczne wykrywanie drukarek, serwerów multimediów i innych urządzeń bez ingerencji użytkownika. Technologia AirDrop firmy Apple oraz Chromecast firmy Google wykorzystują mDNS jako mechanizm wykrywania urządzeń w sieci lokalnej.

Protokół SSDP, będący częścią standardu UPnP, używa podobnej techniki rozgłaszania multicast na adres 239.255.255.250 na porcie 1900. Urządzenia ogłaszają swoją obecność i dostępne usługi za pomocą wiadomości NOTIFY, a klienci mogą aktywnie wyszukiwać urządzenia za pomocą żądania M-SEARCH. W sieciach WLAN nadmierny ruch multicast generowany przez mDNS i SSDP może prowadzić do spadku wydajności, szczególnie w gęsto zaludnionych środowiskach z wieloma urządzeniami. Administratorzy sieci korporacyjnych często ograniczają lub blokują te protokoły, aby zachować kontrolę nad ruchem.

42/58
UPnP (Universal Plug and Play)
Cel slajdu: Slajd przedstawia automatykę UPnP IGD jako wygodę okupioną ryzykiem samowolnego otwierania portów.

Automatyzacja konfiguracji sieciowej

  • UPnP to zbiór protokołów warstwy aplikacji, którego celem jest ułatwienie komunikacji między urządzeniami w sieci lokalnej.
  • Jedną z jego najbardziej znanych (i kontrowersyjnych) funkcji jest IGD (Internet Gateway Device).
  • Pozwala on aplikacjom na naszym komputerze (np. grom P2P) na automatyczne konfigurowanie routera i otwieranie portów (tworzenie reguł NAT).
  • Zamiast ręcznie logować się do routera i przekierowywać port, aplikacja sama wysyła do routera (który musi wspierać UPnP) polecenie: "Proszę, przekieruj ruch z publicznego portu 12345 na mój wewnętrzny port 12345".
  • Ułatwia to życie, ale bywa też krytykowane jako potencjalna dziura w bezpieczeństwie.
Automatyka UPnP IGD (ang. Internet Gateway Device): Zbiór protokołów wykrywania i sterowania pozwala aplikacjom, takim jak gry P2P, samodzielnie otwierać mapowania portów NAT na żądanie. Ułatwia to życie domowym użytkownikom WLAN, lecz złośliwe oprogramowanie otwiera w ten sposób dostęp do sieci. Zaleca się wyłączanie automatyki i ręczne reguły, choć nowsze implementacje dodają uwierzytelnianie.
UPnP (Universal Plug and Play)

Standard UPnP został opracowany przez organizację UPnP Forum w celu uproszczenia konfiguracji urządzeń sieciowych w środowiskach domowych i małych biurach. Architektura UPnP opiera się na protokołach internetowych, w tym IP, TCP, UDP i HTTP, i definiuje mechanizmy wykrywania urządzeń, opisywania ich możliwości oraz sterowania nimi. Funkcja IGD w standardzie UPnP umożliwia automatyczne przekierowywanie portów na routerze, co jest wykorzystywane przez gry komputerowe i aplikacje komunikacyjne do ustanawiania bezpośrednich połączeń przez NAT. W sieciach WLAN uproszczenie konfiguracji oferowane przez UPnP jest szczególnie cenne dla mniej doświadczonych użytkowników.

Z punktu widzenia bezpieczeństwa UPnP budzi kontrowersje, ponieważ automatyzacja przekierowywania portów może być wykorzystana przez złośliwe oprogramowanie do otwarcia dostępu do wewnętrznych zasobów sieci. W sieciach WLAN szczególnie narażonych na ataki zaleca się wyłączenie funkcji UPnP na routerze i punktach dostępowych, a w zamian manualne konfigurowanie przekierowań portów tylko dla niezbędnych usług. Współczesne implementacje UPnP coraz częściej oferują mechanizmy uwierzytelniania i autoryzacji, ale w praktyce większość urządzeń konsumenckich nadal działa w trybie domyślnym bez kontroli dostępu.

43/58
Bezpieczeństwo w Warstwie Aplikacji
Cel slajdu: Slajd systematyzuje zagrożenia warstwy aplikacji: wstrzykiwanie SQL, skrypty XSS i phishing.

Najczęstszy cel ataków

  • Warstwa aplikacji jest najczęstszym celem ataków, ponieważ jest najbliżej danych użytkownika i często zawiera luki w implementacji.
  • Zagrożenia są bardzo różnorodne.
  • Mogą to być ataki na aplikacje webowe, takie jak SQL Injection (wstrzykiwanie złośliwego kodu SQL do zapytań do bazy danych) czy Cross-Site Scripting (XSS) (wstrzykiwanie złośliwego kodu JavaScript do strony WWW).
  • Inne zagrożenia to malware (wirusy, trojany), które wykorzystują protokoły aplikacyjne do rozprzestrzeniania się, oraz phishing, czyli ataki socjotechniczne, w których atakujący podszywa się pod zaufaną usługę (np. bank), aby wyłudzić poświadczenia.
Zagrożenia warstwy aplikacji (SQL Injection, XSS, phishing): Warstwa najbliższa danym jest najczęstszym celem: wstrzyknięcie SQL przemycają złośliwe zapytanie do bazy, skrypty międzywitrynowe wstrzykują JavaScript do strony ofiary, a phishing podszywa się pod bank. Obronę stanowią walidacja danych, zapytania parametryzowane, polityki CSP, skanery podatności oraz TLS przeciw manipulacji i pośrednikowi.
Bezpieczeństwo w Warstwie Aplikacji

Ataki na warstwę aplikacji są szczególnie niebezpieczne, ponieważ działają na poziomie, który jest widoczny dla użytkownika i może prowadzić do bezpośredniego przejęcia danych wrażliwych. Ataki typu SQL Injection polegają na wstrzyknięciu złośliwego kodu SQL do pola wejściowego aplikacji webowej, co może doprowadzić do nieautoryzowanego dostępu do bazy danych. W sieciach WLAN ryzyko takich ataków nie różni się od sieci przewodowych, ponieważ działają one na poziomie aplikacji, a nie transmisji. Ataki XSS polegają na wstrzyknięciu złośliwego kodu JavaScript do strony WWW, który następnie wykonuje się w przeglądarce ofiary, umożliwiając kradzież ciasteczek sesyjnych lub przekierowanie na fałszywe strony.

Ochrona przed atakami na warstwę aplikacji wymaga wielowarstwowego podejścia, obejmującego walidację danych wejściowych, stosowanie przygotowanych zapytań SQL, używanie nagłówka Content Security Policy oraz regularne skanowanie podatności. W sieciach WLAN dodatkowym zabezpieczeniem jest stosowanie szyfrowania TLS, które uniemożliwia manipulację danymi przesyłanymi między klientem a serwerem. Ataki phishingowe w sieciach WLAN są szczególnie skuteczne, ponieważ użytkownicy mogą być przekierowani na fałszywe strony logowania po połączeniu się z niebezpiecznym punktem dostępowym.

44/58
Firewall Warstwy Aplikacji (WAF)
Cel slajdu: Slajd opisuje zaporę aplikacyjną WAF jako inspekcję treści HTTP za terminacją TLS.

Inteligentna ochrona usług

  • Tradycyjny firewall warstwy 3/4 filtruje ruch na podstawie adresów IP i portów.
  • Nie jest on jednak w stanie zrozumieć, co dzieje się wewnątrz samej komunikacji aplikacyjnej.
  • Do tego służy WAF (Web Application Firewall).
  • Jest to specjalizowany firewall, który działa na warstwie 7 i potrafi analizować treść żądań i odpowiedzi HTTP.
  • Rozumie on logikę protokołu i potrafi wykryć próby ataków, takich jak SQL Injection czy XSS, nawet jeśli przechodzą one przez standardowy, dozwolony port 443.
  • WAF działa jak inteligentny strażnik stojący przed serwerem WWW, który dokładnie sprawdza "zawartość każdej przesyłki", a nie tylko jej "adres".
Zapora aplikacyjna WAF (ang. Web Application Firewall): Klasyczna zapora filtruje adresy i porty, natomiast WAF analizuje treść żądań HTTP, logikę protokołu i anomalie uczeniem maszynowym już za terminacją TLS na porcie 443. Wykrywa wstrzyknięcia i skrypty po znakach w URL, limitach tempa i nagłówkach. Wdraża się ją sprzętowo albo chmurowo przed serwerami z aktualnymi regułami.
Firewall Warstwy Aplikacji (WAF)

Zapora ogniowa warstwy aplikacji działa jako pośrednik między klientem a serwerem, analizując treść żądań HTTP i blokując te, które zawierają podejrzane wzorce. WAF rozpoznaje składnię protokołu HTTP i jest w stanie wykryć próby ataków nawet w zaszyfrowanym ruchu HTTPS, jeśli znajduje się za punktem zakończenia TLS. W sieciach WLAN WAF może być wdrożony jako urządzenie sprzętowe w centrum danych lub jako usługa w chmurze, ochraniająca aplikacje dostępne przez Internet. WAF działa na podstawie zestawów reguł, które definiują charakterystyki ataków, oraz mechanizmów uczenia maszynowego wykrywających anomalie behawioralne.

Typowe reguły WAF obejmują blokowanie żądań zawierających znaki specjalne w parametrach URL, ograniczenie szybkości żądań z jednego adresu IP oraz weryfikację nagłówka User-Agent. WAF może również chronić przed atakami DDoS na poziomie aplikacji poprzez wykrywanie wzorców charakterystycznych dla botnetów. W sieciach WLAN gęsto zaludnionych, takich jak kampusy uniwersyteckie, WAF pomaga zabezpieczyć systemy informatyczne przed atakami pochodzącymi z sieci studenckich. Poprawna konfiguracja WAF wymaga znajomości architektury chronionej aplikacji oraz regularnej aktualizacji reguł w odpowiedzi na nowo odkryte podatności.

45/58
Captive Portal
Cel slajdu: Slajd wyjaśnia portal captive jako przechwytywanie ruchu do strony logowania bez szyfrowania sesji.

Logowanie do publicznych sieci Wi-Fi

  • Kiedy łączymy się z publiczną siecią Wi-Fi w hotelu lub na lotnisku, często pierwszą rzeczą, jaką widzimy, jest strona logowania lub strona z regulaminem, którą musimy zaakceptować.
  • Mechanizm ten, zwany Captive Portal, to inteligentne wykorzystanie protokołów warstw wyższych.
  • Po połączeniu się z siecią, punkt dostępowy lub router przechwytuje wszystkie nasze żądania DNS i HTTP.
  • Niezależnie od tego, jaką stronę próbujemy otworzyć, system przekierowuje nas na lokalną stronę portalu.
  • Dopiero po pomyślnym uwierzytelnieniu (np. podaniu numeru pokoju lub akceptacji regulaminu), firewall "otwiera" nam dostęp do Internetu.
Portal captive (ang. captive portal): Sieci hotelowe i lotniskowe przechwytują zapytania DNS i HTTP do czasu akceptacji regulaminu na stronie logowania, wykrywanej przez systemowe adresy testowe. Po uwierzytelnieniu adres MAC trafia na listę dostępu i zapora otwiera Internet, opcjonalnie z serwerem RADIUS. Portal nie szyfruje ruchu, więc w publicznych WLAN zaleca się HTTPS i VPN.
Captive Portal

Mechanizm Captive Portal jest powszechnie stosowany w publicznych sieciach WLAN jako metoda uwierzytelniania i akceptacji regulaminu przed uzyskaniem dostępu do Internetu. Działanie portalu opiera się na przechwytywaniu ruchu DNS i HTTP od nowo podłączonych klientów oraz przekierowywaniu ich na lokalną stronę logowania. Systemy operacyjne wykrywają obecność Captive Portal poprzez wysłanie zapytania do specjalnie zdefiniowanego adresu URL, na przykład http://captive.apple.com dla urządzeń Apple, i sprawdzenie, czy odpowiedź jest zgodna z oczekiwaną. Po pomyślnym uwierzytelnieniu punkt dostępowy lub kontroler WLAN dodaje adres MAC urządzenia do listy dozwolonych, umożliwiając swobodny dostęp do Internetu.

Captive Portal może przechowywać informacje o sesjach użytkowników w bazie danych lub w systemie zewnętrznym, co umożliwia generowanie raportów z użytkowania sieci i monitorowanie aktywności. W niektórych implementacjach Captive Portal integruje się z systemem RADIUS do centralnego uwierzytelniania użytkowników, co pozwala na wykorzystanie tych samych poświadczeń w wielu lokalizacjach. W kontekście bezpieczeństwa Captive Portal nie zapewnia szyfrowania transmisji, dlatego użytkownicy publicznych sieci WLAN powinni zawsze korzystać z HTTPS i VPN w celu ochrony swojej prywatności.

Współczesne urządzenia mobilne nie czekają, aż użytkownik ręcznie wpisze adres HTTP w przeglądarce. Korzystają z wbudowanych mechanizmów detekcji Captive Portal – zaraz po przypisaniu adresu IP próbują połączyć się z odgórnie zdefiniowaną domeną (np. captive.apple.com dla urządzeń Apple, msftconnecttest.com dla Windows, connectivitycheck.gstatic.com dla Androida). Jeśli odpowiedź zostanie przechwycona lub przekierowana, system automatycznie wyświetla okienko logowania. Wiedza ta jest niezbędna przy diagnostyce problemów z sieciami gośćinnymi.

46/58
Architektura Chmurowa i Mikrousługi
Cel slajdu: Slajd przedstawia chmurę i mikrousługi z orkiestracją kontenerów jako architekturę aplikacji internetowych.

Jak budowane są nowoczesne aplikacje?

  • Współczesne, duże aplikacje internetowe (np. Netflix, Uber) rzadko są już jednym, monolitycznym programem.
  • Zamiast tego, budowane są w architekturze mikrousług (microservices).
  • Cała aplikacja jest podzielona na dziesiątki lub setki małych, niezależnych usług, z których każda odpowiada za jedną, konkretną funkcję (np. autoryzacja użytkownika, obsługa koszyka, rekomendacje).
  • Te mikrousługi komunikują się ze sobą nawzajem przez sieć, najczęściej za pomocą lekkich protokołów i API (np. REST przez HTTP).
  • Taka architektura, hostowana w chmurze, jest niezwykle elastyczna, skalowalna i odporna na awarie.
Architektura chmurowa i mikrousługi (Docker, Kubernetes): Monolit dzieli się na dziesiątki usług pokroju uwierzytelniania i koszyka, komunikujących się przez REST z JSON albo gRPC w kontenerach orkiestrowanych przez Kubernetes. Daje to elastyczność i odporność przy wsparciu DNS, równoważenia i CDN w chmurze. Wyzwaniem są opóźnienia WLAN między usługami oraz złożone monitorowanie rozproszonych śladów.
Architektura Chmurowa i Mikrousługi

Architektura mikrousług dzieli duże aplikacje na niezależne, luźno powiązane komponenty, z których każdy odpowiada za pojedynczą funkcję biznesową i może być rozwijany, testowany i wdrażany niezależnie od pozostałych. Każda mikrousługa komunikuje się z innymi za pośrednictwem lekkich protokołów, najczęściej HTTP z formatem JSON lub protokołu gRPC, co umożliwia implementację każdej z nich w innym języku programowania. W sieciach WLAN wydajność komunikacji między mikrousługami jest zależna od opóźnień na łączu radiowym, co w przypadku rozproszonych systemów chmurowych może być istotnym czynnikiem ograniczającym. Konteneryzacja za pomocą Dockera i zarządzanie za pomocą Kubernetes stały się standardem wdrażania i orkiestracji mikrousług.

Architektura chmurowa umożliwia elastyczne skalowanie zasobów w zależności od zapotrzebowania, co w przypadku aplikacji obsługujących klientów poprzez sieci WLAN ma kluczowe znaczenie podczas szczytów obciążenia. Platformy chmurowe oferują usługi zarządzanego DNS, równoważenia obciążenia i sieci CDN, które optymalizują dostarczanie treści do użytkowników końcowych w sieciach WLAN. W architekturze mikrousług monitorowanie i diagnostyka są bardziej złożone niż w aplikacjach monolitycznych, co wymaga stosowania zaawansowanych narzędzi do śledzenia przepływu żądań i agregacji logów z wielu komponentów.

47/58
Load Balancing
Cel slajdu: Slajd opisuje równoważenie obciążenia w warstwach czwartej i siódmej z algorytmami wyboru serwera.

Rozkładanie obciążenia

  • Popularne usługi internetowe muszą obsługiwać miliony jednoczesnych żądań.
  • Jeden serwer by sobie z tym nie poradził.
  • Dlatego stosuje się load balancing (równoważenie obciążenia).
  • Zamiast jednego serwera, mamy całą farmę identycznych serwerów.
  • Przed nimi stoi specjalne urządzenie lub oprogramowanie – load balancer.
  • Wszystkie żądania od użytkowników trafiają najpierw do load balancera.
  • Jego zadaniem jest inteligentne rozdzielanie tych żądań między dostępne serwery, tak aby żaden z nich nie był przeciążony.
  • Load balancery mogą działać na warstwie 4 (rozdzielając połączenia TCP) lub na warstwie 7 (rozdzielając żądania HTTP, co daje większe możliwości).
Równoważenie obciążenia (ang. load balancing, algorytmy round-robin, least-connections): Dystrybutor rozdziela miliony żądań na farmę serwerów: w warstwie czwartej według adresów i portów TCP, a jako odwrotne proxy w warstwie siódmej inteligentniej według URL i ciasteczek. Algorytmy karuzeli, najmniejszej liczby połączeń i najmniejszych opóźnień dobierają serwer, przy czym lepkość adresowa kłóci się z roamingiem. Chmurowe dystrybutory zarządzane upraszczają wdrożenie.
Load Balancing

Równoważenie obciążenia na warstwie czwartej działa na poziomie połączeń TCP, rozdzielając ruch na podstawie adresów IP i portów bez analizowania treści pakietów. Load balancer warstwy siódmej, zwany również reverse proxy, analizuje treść żądań HTTP, co umożliwia bardziej inteligentne kierowanie ruchu, na przykład na podstawie nagłówka cookie lub adresu URL. W sieciach WLAN load balancer może optymalizować dostarczanie treści poprzez kierowanie klientów do serwera najbliższego geograficznie lub najmniej obciążonego, co skraca czas odpowiedzi. Równoważenie obciążenia jest kluczowym elementem skalowalnych architektur aplikacji webowych, umożliwiającym obsługę milionów jednoczesnych żądań.

Algorytmy równoważenia obciążenia obejmują metody takie jak round-robin, najmniejsza liczba połączeń, najmniejsze opóźnienie oraz haszowanie adresu IP klienta zapewniające stałość sesji. W sieciach WLAN klienci mobilni często zmieniają adresy IP podczas roamingu, co może zakłócić działanie algorytmów opartych na haszowaniu adresu źródłowego. Nowoczesne load balancery obsługują protokół PROXY, który przenosi oryginalny adres IP klienta przez pośredników, co ułatwia diagnostykę i audyt bezpieczeństwa. W chmurze obliczeniowej load balancer jest najczęściej implementowany jako usługa zarządzana, która automatycznie skaluje się w zależności od ruchu.

48/58
CDN (Content Delivery Network)
Cel slajdu: Slajd przedstawia sieć CDN jako globalne serwery brzegowe skracające drogę do treści statycznych.

Przybliżanie treści do użytkownika

  • Pobieranie dużych plików (zdjęć, wideo) z serwera znajdującego się na drugim końcu świata jest wolne.
  • Aby to zoptymalizować, używa się sieci CDN (Content Delivery Network).
  • CDN to globalnie rozproszona sieć serwerów (zwanych "edge servers"), które przechowują kopie statycznych treści (obrazków, plików wideo, CSS) popularnych stron WWW.
  • Kiedy użytkownik w Polsce próbuje pobrać obrazek ze strony hostowanej w USA, system DNS (często wykorzystując anycast) kieruje jego żądanie nie do oryginalnego serwera w USA, ale do najbliższego mu geograficznie serwera CDN, np. w Warszawie.
  • Dzięki temu dane przebywają znacznie krótszą drogę, a strona ładuje się błyskawicznie.
Sieć dostarczania treści CDN (ang. Content Delivery Network): Serwery brzegowe na świecie przechowują kopie obrazów, wideo i skryptów, a DNS z anycast kieruje klienta do najbliższego węzła zamiast przez ocean. Dodatkowo sieć tłumi ataki rozproszone, optymalizuje obrazy i buforuje dynamikę. Jest kluczowa dla szybkiego ładowania i wideo w wolnych publicznych WLAN.
CDN (Content Delivery Network)

Sieć CDN składa się z setek lub tysięcy serwerów brzegowych rozmieszczonych w wielu lokalizacjach na całym świecie i przechowujących kopie statycznych treści popularnych serwisów internetowych. Technologia anycast umożliwia kierowanie żądań klientów do najbliższego geograficznie serwera CDN, co znacząco skraca czas odpowiedzi. W sieciach WLAN wykorzystanie CDN ma szczególne znaczenie, ponieważ umożliwia szybkie ładowanie stron nawet przy relatywnie wolnym łączu bezprzewodowym. CDN przechowuje nie tylko treści statyczne, takie jak obrazy, arkusze stylów i skrypty JavaScript, ale coraz częściej również treści dynamiczne i strumienie wideo.

Współczesne sieci CDN oferują dodatkowe funkcje, takie jak ochrona przed atakami DDoS poprzez rozproszenie ruchu na wiele serwerów, optymalizację obrazów w czasie rzeczywistym oraz przyspieszenie dostarczania treści dynamicznych za pomocą mechanizmów inteligentnego buforowania. W sieciach WLAN publicznych, takich jak lotniska i hotele, CDN odgrywa kluczową rolę w zapewnieniu płynnego strumieniowania wideo i szybkiego dostępu do informacji. Wdrożenie CDN jest szczególnie zalecane dla serwisów o globalnym zasięgu, ponieważ redukuje opóźnienia związane z odległością fizyczną między klientem a serwerem.

49/58
WebSockets
Cel slajdu: Slajd opisuje gniazda WebSocket jako trwały dwukierunkowy kanał po uzgodnieniu z HTTP.

Dwukierunkowa komunikacja w czasie rzeczywistym

  • Standardowy protokół HTTP działa w modelu żądanie-odpowiedź, co nie jest idealne dla aplikacji wymagających natychmiastowej, dwukierunkowej komunikacji (np. czaty, aplikacje giełdowe).
  • Rozwiązaniem tego problemu jest protokół WebSocket.
  • Jest on inicjowany przez "upgrade" standardowego połączenia HTTP.
  • Po nawiązaniu, tworzy on trwałe, dwukierunkowe połączenie TCP między przeglądarką a serwerem.
  • Od tego momentu serwer może wysyłać dane do przeglądarki w dowolnym momencie, bez potrzeby oczekiwania na jej żądanie.
  • Pozwala to na tworzenie prawdziwie interaktywnych aplikacji webowych, które aktualizują się w czasie rzeczywistym.
Gniazda WebSocket (RFC 6455, odmiana WSS): Po uzgodnieniu w nagłówkach HTTP połączenie TCP staje się trwałym, dwukierunkowym kanałem z minimalnym narzutem dla danych tekstowych i binarnych. Serwer wysyła powiadomienia bez odpytywania, co napędza czaty, notowania i współpracę na żywo. Odmiana szyfrowana na porcie 443 chroni w publicznych WLAN, a roaming wymaga automatycznego ponawiania połączenia.
WebSockets

Protokół WebSocket, znormalizowany przez IETF w dokumencie RFC 6455, umożliwia ustanowienie trwałego, dwukierunkowego kanału komunikacyjnego między przeglądarką a serwerem za pomocą pojedynczego połączenia TCP. Inicjalizacja połączenia WebSocket rozpoczyna się od standardowego żądania HTTP, które zawiera nagłówek Upgrade: websocket informujący serwer o zamiarze przejścia na protokół WebSocket. Po potwierdzeniu przez serwer, połączenie przełącza się z protokołu HTTP na WebSocket, a dane są przesyłane w ramkach o małym narzucie protokołowym. W sieciach WLAN WebSocket jest szczególnie użyteczny dla aplikacji wymagających niskich opóźnień i częstej dwukierunkowej komunikacji, takich jak czaty online i narzędzia do współpracy w czasie rzeczywistym.

W przeciwieństwie do tradycyjnego podejścia z cyklicznym odpytywaniem serwera, WebSocket pozwala na natychmiastowe przesyłanie danych od serwera do klienta bez opóźnień związanych z nawiązywaniem nowych połączeń HTTP. W sieciach WLAN stabilność połączenia WebSocket może być zagrożona podczas roamingu między punktami dostępowymi, co wymaga implementacji automatycznego ponownego łączenia po stronie klienta. WebSocket wspiera również transmisję danych binarnych, co jest wykorzystywane w grach przeglądarkowych i aplikacjach strumieniujących. Zabezpieczona wersja WebSocket Secure działa przez TLS na porcie 443, co zapewnia szyfrowanie transmisji i uniemożliwia podsłuch w publicznych sieciach WLAN.

50/58
Kapsułkowanie w praktyce: Przeglądanie strony
Cel slajdu: Slajd śledzi podróż kliknięcia w dół stosu od zapytania HTTP przez TLS i TCP po ramkę radiową.

Pełna podróż danych

  • Prześledźmy całą drogę, jaką pokonują dane, gdy otwieramy stronę WWW w sieci Wi-Fi.
    1. L7 (Aplikacji): Przeglądarka tworzy żądanie HTTP GET. Pyta DNS o adres IP serwera.
    2. L6 (Prezentacji): Nawiązywana jest sesja TLS, żądanie HTTP jest szyfrowane.
    3. L5 (Sesji): Zarządzany jest logiczny dialog z serwerem.
    4. L4 (Transportowa): Zaszyfrowane dane są dzielone na segmenty TCP.
    5. L3 (Sieciowa): Do segmentów dodawany jest nagłówek IP, tworząc pakiety adresowane do serwera.
    6. L2 (Łącza Danych): Pakiety IP są pakowane w ramki 802.11, adresowane do adresu MAC punktu dostępowego.
    7. L1 (Fizyczna): Ramki są zamieniane na sygnał radiowy i wysyłane w eter.
  • Na każdym etapie, od AP, przez routery, aż do serwera, zachodzą odpowiednie procesy dekapsułkacji i ponownej kapsułkacji.
Kapsułkowanie na przykładzie przeglądania strony: Kliknięcie startuje od rozwiązania DNS i żądania HTTP, które TLS szyfruje, warstwa sesji układa w dialog, TCP tnie na segmenty, IP opakowuje w pakiety, a warstwa druga w ramki 802.11 do adresu punktu dostępowego emitowane radiowo. Po drodze punkt zdejmuje ramkę radiową, routery trasują po IP, a serwer odtwarza HTTP. Scenariusz pokazuje współpracę wszystkich warstw OSI.
Kapsułkowanie w praktyce: Przeglądanie strony

Proces kapsułkowania danych podczas przeglądania strony internetowej ilustruje współpracę wszystkich warstw modelu OSI, od aplikacji aż po warstwę fizyczną. Na przykładzie żądania HTTP widać, jak dane są stopniowo opakowywane w kolejne nagłówki: na warstwie aplikacji powstaje żądanie HTTP, które jest następnie szyfrowane przez TLS na warstwie prezentacji. Warstwa transportowa dzieli dane na segmenty TCP z numerami sekwencyjnymi i portami, a warstwa sieciowa dodaje nagłówek IP z adresami źródłowym i docelowym. Warstwa łącza danych tworzy ramkę 802.11 z adresami MAC punktu dostępowego i stacji klienckiej, a warstwa fizyczna moduluje ramkę na sygnał radiowy.

Po stronie punktu dostępowego odbiorczego następuje proces odwrotny, czyli dekapsułkacja, w którym kolejne warstwy usuwają nagłówki i przekazują dane w górę stosu protokołów. Punkt dostępowy usuwa ramkę 802.11, odczytuje docelowy adres MAC i przekazuje pakiet IP przez interfejs przewodowy do sieci szkieletowej. W routerach na trasie pakietu warstwa sieciowa analizuje docelowy adres IP i podejmuje decyzje routingu, a warstwa łącza danych tworzy nowe ramki odpowiednie dla danego medium fizycznego. W docelowym serwerze WWW proces dekapsułkacji przebiega aż do warstwy aplikacji, gdzie serwer odczytuje żądanie HTTP i przygotowuje odpowiedź.

51/58
Znaczenie QoS End-to-End
Cel slajdu: Slajd uzasadnia spójne znakowanie jakości od WMM w radiu po DSCP w szkielecie dla głosu i obrazu.

Spójna priorytetyzacja na całej trasie

  • Aby usługa Quality of Service działała skutecznie, priorytety muszą być respektowane na całej trasie komunikacji.
  • Nie wystarczy, że nasza sieć Wi-Fi, dzięki WMM (L2), nada wysoki priorytet pakietom VoIP.
  • Te oznaczenia muszą być "przetłumaczone" na odpowiednie znaczniki DSCP w nagłówku IP (L3).
  • Dzięki temu routery w internecie również będą wiedziały, że te pakiety są ważne.
  • Podobnie, sieć szkieletowa musi być skonfigurowana tak, aby honorować te znaczniki.
  • Tylko spójne i konsekwentne oznaczanie i traktowanie ruchu na warstwach 2, 3 i wyższych może zapewnić prawdziwą jakość usług "od końca do końca".
Jakość usług end-to-end (WMM a DSCP): Same priorytety radiowe WMM nie wystarczą, jeśli routery szkieletowe ich nie honorują, dlatego klasy głosu, obrazu, wysiłku i tła mapuje się na znaczniki DSCP warstwy trzeciej. Bez translacji priorytety gubią się na styku przewodowym. Tylko spójne oznaczanie w warstwach drugiej, trzeciej i wyższych daje prawdziwą jakość dla VoIP i wideo.
Znaczenie QoS End-to-End

Jakość usług w sieciach WLAN wymaga spójnego oznaczania ruchu na wszystkich warstwach, począwszy od ramek 802.11 z priorytetami WMM aż po znaczniki DSCP w pakietach IP. Mechanizm WMM, oparty na standardzie IEEE 802.11e, definiuje cztery kategorie dostępu: głosową, wideo, best-effort i tło, które odpowiadają różnym poziomom priorytetu transmisji. Kategorie te są mapowane na odpowiednie wartości DSCP w warstwie sieciowej, co zapewnia spójne traktowanie ruchu przez wszystkie urządzenia na trasie transmisji. W sieciach WLAN priorytetyzacja głosu i wideo ma kluczowe znaczenie dla jakości rozmów VoIP i wideokonferencji.

Skuteczne działanie QoS end-to-end wymaga prawidłowej konfiguracji wszystkich urządzeń na trasie pakietu, w tym punktów dostępowych, przełączników i routerów. Znaczniki DSCP są ustawiane przez urządzenie źródłowe lub przez zaufany przełącznik brzegowy i są respektowane przez routery w sieci szkieletowej. W sieciach WLAN problemem jest fakt, że oznaczenia priorytetów WMM są usuwane podczas transmisji przez łącze przewodowe, jeśli nie zostaną poprawnie przetłumaczone na znaczniki warstwy trzeciej. Tylko spójne i konsekwentne oznaczanie i traktowanie ruchu na warstwach 2, 3 i wyższych może zapewnić prawdziwą jakość usług od końca do końca.

52/58
Problemy z NAT i aplikacje
Cel slajdu: Slajd opisuje konflikty starszych aplikacji z NAT i rolę bramek aplikacyjnych ALG.

Gdy protokół nie lubi translacji

  • Niektóre starsze protokoły warstwy aplikacji źle znoszą mechanizm NAT.
  • Przykładem jest FTP w trybie aktywnym.
  • W tym trybie, klient, po nawiązaniu połączenia kontrolnego, informuje serwer: "Otwórz połączenie danych na mój adres IP 192.168.1.10 i port X".
  • Oczywiście, serwer w internecie nie ma pojęcia, jak połączyć się z adresem prywatnym.
  • Podobne problemy występują w protokole SIP, który w swoich wiadomościach również przesyła adresy IP.
  • Aby rozwiązać te problemy, nowoczesne routery posiadają funkcję ALG (Application-Layer Gateway).
  • Router "zagląda" do środka pakietów tych problematycznych protokołów i inteligentnie podmienia adresy prywatne na publiczne, pozwalając im działać przez NAT.
Problemy aplikacji z NAT i bramki ALG: Starsze protokoły niosą adres IP w treści, jak aktywny FTP w komendzie PORT czy SIP, więc NAT zmieniający tylko nagłówek uniemożliwia powrót do adresu prywatnego. Bramka aplikacyjna ALG w routerze inspektuje treść i podmienia adresy z portami. Nowoczesne protokoły projektuje się z myślą o NAT z pomocą STUN i ICE, a wadliwa bramka bywa gorsza niż jej brak.
Problemy z NAT i aplikacje

Problemy z NAT w przypadku protokołów takich jak FTP i SIP wynikają z faktu, że protokoły te przesyłają adresy IP i numery portów wewnątrz swoich wiadomości, a nie tylko w nagłówkach pakietów. Gdy router wykonuje translację adresów, zmienia adres źródłowy w nagłówku IP, ale nie modyfikuje adresów zapisanych w treści wiadomości aplikacyjnej. W przypadku aktywnego FTP klient przesyła serwerowi swój prywatny adres IP w poleceniu PORT, a serwer próbując nawiązać połączenie danych, kieruje je na adres prywatny, który nie jest dostępny z Internetu. W sieciach WLAN problem ten jest szczególnie widoczny ze względu na powszechne stosowanie translacji NAT w routerach domowych i biurowych.

Mechanizm ALG w routerach rozwiązuje ten problem poprzez inteligentną inspekcję treści pakietów protokołów takich jak FTP i SIP. Router jako ALG analizuje wiadomości aplikacyjne i modyfikuje adresy IP oraz numery portów w treści pakietów, dopasowując je do rzeczywistych adresów po translacji NAT. W nowoczesnych sieciach WLAN znaczenie ALG maleje, ponieważ coraz więcej protokołów jest projektowanych z uwzględnieniem NAT, a popularność zyskują techniki takie jak STUN i ICE, które pozwalają na wykrywanie adresów publicznych. Nieprawidłowo skonfigurowany ALG może jednak powodować problemy z działaniem innych protokołów.

53/58
Architektura sieci a wydajność aplikacji
Cel slajdu: Slajd przypomina, że wąskim gardłem bywa łącze operatora, DNS albo serwer, a nie samo radio Wi-Fi.

Dlaczego "szybkie Wi-Fi" nie zawsze wystarcza?

  • Na koniec warto podkreślić, że odczuwalna przez użytkownika wydajność aplikacji zależy od całej ścieżki sieciowej, a nie tylko od ostatniego, bezprzewodowego odcinka.
  • Możemy mieć najnowszy router Wi-Fi 6E, ale jeśli nasze połączenie z internetem jest wolne, serwer DNS odpowiada z opóźnieniem, a serwer docelowy jest przeciążony, to strony i tak będą ładować się wolno.
  • Każda warstwa i każdy element na trasie – od klienta, przez AP, router, sieć ISP, aż po serwer docelowy – dokłada swoje opóźnienie (latency) i stanowi potencjalne "wąskie gardło" (bottleneck).
  • Diagnozowanie problemów z wydajnością wymaga holistycznego spojrzenia na cały stos komunikacyjny.
Wydajność a architektura sieci: Nawet szybkie Wi-Fi 6E nie pomoże przy wolnym łączu dostępowym, opieszałym DNS albo przeciążonym serwerze, bo każdy element od klienta przez punkt i routera po serwer dokłada opóźnienie. Diagnostyka holistyczna pingiem, traceroute i iperf na odcinkach wskazuje winowajcę. Często za wolną aplikację odpowiada konfiguracja serwera, a nie interferencje radiowe.
Architektura sieci a wydajność aplikacji

Wydajność aplikacji odczuwalna przez użytkownika końcowego w sieci WLAN jest wypadkową wielu czynników, z których tylko część jest związana z samym łączem bezprzewodowym. Opóźnienie na łączu radiowym, zależne od odległości od punktu dostępowego, liczby współbieżnych użytkowników i poziomu zakłóceń, jest tylko jedną ze składowych całkowitego czasu odpowiedzi. Do tego dochodzą opóźnienia na routerach pośrednich, czas przetwarzania na serwerze DNS, opóźnienia związane z nawiązywaniem połączeń TLS oraz wydajność samego serwera aplikacji. W sieciach WLAN holistyczne podejście do diagnostyki wymaga pomiarów na wszystkich etapach ścieżki komunikacyjnej.

Identyfikacja wąskich gardeł w sieci WLAN wymaga systematycznego testowania poszczególnych segmentów ścieżki transmisyjnej. Narzędzia takie jak ping i traceroute pozwalają na pomiar opóźnień i identyfikację węzłów powodujących opóźnienia, a iperf umożliwia pomiar przepustowości na różnych odcinkach. W praktyce administracyjnej często okazuje się, że problem nie leży w sieci WLAN, ale w przeciążonym łączu internetowym, wolno odpowiadającym serwerze DNS lub nieoptymalnej konfiguracji serwera aplikacji. Kompleksowa diagnostyka wydajności w sieciach WLAN wymaga spojrzenia na cały stos komunikacyjny.

54/58
Podsumowanie Warstw Wyższych
Cel slajdu: Slajd podsumowuje warstwy wyższe jako zamianę pakietów w użyteczne, niezawodne i bezpieczne usługi.

Od niezawodności po aplikacje

  • Warstwy wyższe modelu OSI (4-7) odpowiadają za przekształcenie surowych możliwości przesyłania pakietów w użyteczne, niezawodne i bezpieczne usługi.
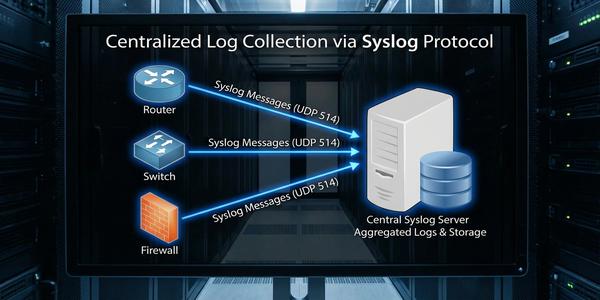
  • Warstwa transportowa, z jej kluczowymi protokołami TCP i UDP, decyduje o charakterze komunikacji.
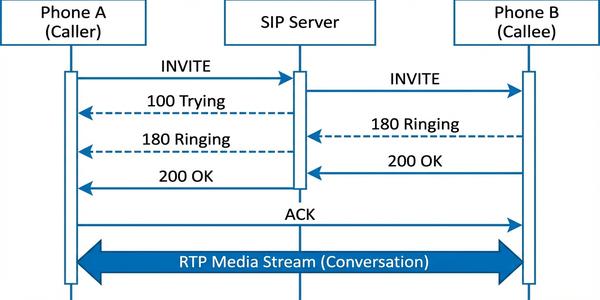
  • Warstwy sesji i prezentacji, choć często ukryte, dbają o uporządkowanie dialogu, formatowanie danych i szyfrowanie.
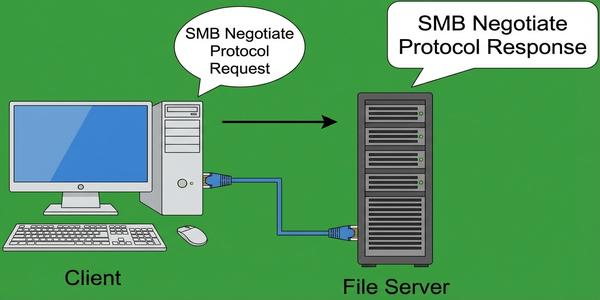
  • Na samym szczycie, warstwa aplikacji dostarcza nam konkretne protokoły, które napędzają nasz cyfrowy świat – od przeglądania stron, przez wysyłanie e-maili, po rozmowy wideo.
  • Każda z tych warstw dokłada swoją "cegiełkę", tworząc razem skomplikowaną, ale spójną architekturę, która umożliwia działanie globalnego Internetu.
Synteza warstw wyższych (L4-L7): Transport TCP i UDP decyduje o charakterze transmisji, sesja porządkuje dialogi, prezentacja formatuje i szyfruje, a aplikacja dostarcza konkretne protokoły WWW, poczty i wideo. Problemy radia WLAN wracają w postaci retransmisji i opóźnień, a błędy konfiguracji warstwy siódmej myli się z zanikami sygnału. Rozróżnienie to jest kluczem do trafnej diagnostyki.
Podsumowanie Warstw Wyższych

Podsumowanie warstw wyższych modelu OSI pokazuje, jak ogromny postęp dokonał się w dziedzinie komunikacji sieciowej na przestrzeni ostatnich dekad. Warstwa transportowa z protokołami TCP i UDP stanowi fundament, na którym opiera się cała komunikacja między zastosowaniami, oferując różne poziomy niezawodności i wydajności. Warstwa sesji i prezentacji, choć często niewidoczne dla użytkownika końcowego, odgrywają istotną rolę w organizacji dialogu między aplikacjami oraz w zapewnieniu bezpieczeństwa i kompatybilności danych. Warstwa aplikacji, będąca najbardziej zewnętrzną warstwą, dostarcza konkretnych protokołów, które umożliwiają korzystanie z usług internetowych.

W kontekście sieci WLAN wszystkie te warstwy są równie ważne, a zrozumienie ich wzajemnych zależności jest kluczem do efektywnego projektowania i diagnostyki sieci. Problemy na niższych warstwach, takie jak zakłócenia radiowe czy przeciążenie punktu dostępowego, mają bezpośredni wpływ na działanie protokołów wyższych warstw, powodując retransmisje TCP i zwiększone opóźnienia aplikacji. Z kolei błędy w konfiguracji protokołów warstwy aplikacji mogą być błędnie interpretowane jako problemy z łączem radiowym. Kompleksowa wiedza o wszystkich warstwach modelu OSI pozwala na skuteczną diagnostykę i optymalizację sieci WLAN.

55/58
Koniec serii wykładów
Cel slajdu: Slajd zamyka cały kurs od fal radiowych po aplikacje i wskazuje kierunki rozwoju Wi-Fi i 5G.

Podsumowanie całego kursu

  • Szanowni Państwo, dotarliśmy do końca naszej podróży przez świat sieci komputerowych, od fizycznej transmisji fal radiowych aż po protokoły aplikacji.
  • Mam nadzieję, że ten kurs dał Państwu solidne podstawy i pozwolił zrozumieć, jak skomplikowane i fascynujące mechanizmy kryją się za prostą czynnością połączenia się z siecią Wi-Fi.
  • Zrozumienie, jak działają poszczególne warstwy i jak współpracują ze sobą, jest kluczem do świadomego projektowania, konfigurowania i diagnozowania problemów w każdej sieci.
  • Dziękuję Państwu za uwagę, zaangażowanie i wszystkie pytania.
  • Życzę powodzenia na egzaminie i w dalszej karierze zawodowej.
Zwieńczenie kursu WLAN: Kurs poprowadził od fal i modulacji przez adresy MAC, ramki i szyfrowanie, adresację IP i routing aż po transport i aplikacje, pokazując Wi-Fi jako złożony mechanizm współpracy warstw. Perspektywami są Wi-Fi 7 z kanałami 320 MHz i modulacją 4096-QAM oraz sieci 5G i 6G z ewolucją kontroli zatłoczenia, TLS i bezpieczeństwa. Zrozumienie tych zależności przygotowuje do egzaminu i pracy inżynierskiej.
Koniec serii wykładów

Kończąc serię wykładów o sieciach WLAN, warto spojrzeć w przyszłość i zastanowić się nad kierunkami rozwoju technologii bezprzewodowych. Standard Wi-Fi 7, oparty na IEEE 802.11be, wprowadzi jeszcze wyższe prędkości transmisji dzięki szerszym kanałom 320 MHz i zaawansowanej modulacji 4096-QAM. Równocześnie rozwijają się technologie 5G i 6G, które będą konkurować i uzupełniać tradycyjne sieci WLAN w zastosowaniach wymagających niskich opóźnień i wysokiej niezawodności. Warstwy wyższe stosu protokołów będą musiały dostosować się do tych zmian, oferując jeszcze lepsze mechanizmy kontroli zatłoczenia, szybsze nawiązywanie połączeń i skuteczniejsze zabezpieczenia.

Zrozumienie mechanizmów działania wszystkich warstw modelu OSI, od fizycznej transmisji fal radiowych aż po protokoły aplikacyjne, daje absolwentom kierunków IT solidne podstawy do dalszego rozwoju zawodowego. Wiedza ta jest niezbędna nie tylko dla administratorów sieci, ale także dla programistów aplikacji sieciowych, inżynierów bezpieczeństwa i architektów systemów rozproszonych. Zachęcam do dalszego zgłębiania tajników sieci komputerowych, ponieważ jest to dziedzina, która nieustannie ewoluuje i oferuje coraz to nowe wyzwania oraz możliwości rozwoju.

56/58
Bezpieczeństwo WLAN: od WEP do WPA3
Cel slajdu: Slajd porządkuje ewolucję zabezpieczeń od złamanego WEP przez WPA2 z luką KRACK po odporny WPA3.
  • Bezpieczeństwo sieci bezprzewodowych to jedno z najważniejszych zagadnień w kontekście warstw wyższych modelu OSI.
  • WEP (Wired Equivalent Privacy) – pierwszy standard bezpieczeństwa Wi-Fi, szybko złamany ze względu na krótki wektor inicjalizacyjny (IV) i słabości algorytmu RC4. Całkowicie wycofany.
  • WPA (Wi-Fi Protected Access) – tymczasowe rozwiązanie wprowadzające protokół TKIP (Temporal Key Integrity Protocol) jako łatkę na WEP. Również uznany za niewystarczający.
  • WPA2 (IEEE 802.11i) – pełny standard bezpieczeństwa wykorzystujący szyfrowanie AES-CCMP. Obowiązkowy od 2006 roku. Przez lata uznawany za bezpieczny, choć podatny na atak KRACK (2017).
  • WPA3 – najnowszy standard (2018), wprowadzający protokół SAE (Simultaneous Authentication of Equals) zamiast PSK, zapewniający ochronę przed atakami słownikowymi i forward secrecy.
Ewolucja zabezpieczeń WLAN (WEP, WPA2, WPA3, atak KRACK z 2017 roku): Szyfr WEP na RC4 z krótkim wektorem łamano w minuty i wycofano, tymczasowe WPA z TKIP było jedynie łatką, a WPA2 z AES-CCMP stał się standardem naruszonym w 2017 roku atakiem na reinstalację klucza KRACK. WPA3 wprowadza uzgadnianie SAE z tajemnicą przekazywania, odporność na słowniki i obowiązkową ochronę ramek. Historia od 1997 roku to wyścig standardów z łamaniem.

Ewolucja bezpieczeństwa WLAN odzwierciedla nieustanny wyścig między twórcami standardów a osobami próbującymi je łamać. WEP, wprowadzony w 1997 roku, dawał fałszywe poczucie bezpieczeństwa – jego złamanie było możliwe w ciągu kilku minut. WPA było rozwiązaniem przejściowym, wdrożonym zanim finalna wersja IEEE 802.11i (WPA2) została ratyfikowana. WPA3, ratyfikowany w 2018 roku, wprowadza szereg ulepszeń, w tym obowiązkowe ramki zarządzające chronione (PMF/802.11w) oraz 192-bitowe szyfrowanie w trybie Enterprise.

57/58
WPA2/WPA3 Personal vs. Enterprise
Cel slajdu: Slajd zestawia domowy tryb Personal ze wspólnym hasłem z firmowym trybem Enterprise z serwerem RADIUS.
  • Standardy WPA2 i WPA3 oferują dwa tryby pracy:
  • Personal (PSK/SAE): Wszystkie urządzenia współdzielą jedno wspólne hasło (Pre-Shared Key w WPA2, SAE w WPA3). Rozwiązanie proste, stosowane w sieciach domowych i małych biurach (SOHO).
  • Enterprise (802.1X/EAP): Każdy użytkownik posiada indywidualne poświadczenia (login/hasło lub certyfikat). Uwierzytelnianie odbywa się za pośrednictwem serwera RADIUS, a klucze szyfrujące są unikalne dla każdej sesji.
  • W trybie Enterprise punkt dostępowy (AP) pełni rolę pośrednika (Authenticator) między klientem (Supplicant) a serwerem RADIUS (Authentication Server).
  • Protokół EAP (Extensible Authentication Protocol) zapewnia elastyczność – popularne metody to EAP-TLS (certyfikaty), PEAP (login/hasło z tunelem TLS) i EAP-TTLS.
Tryby Personal i Enterprise z EAP (PSK, SAE, 802.1X, serwer RADIUS): Tryb domowy opiera się na wspólnym haśle PSK albo SAE dla wszystkich i jest prosty, natomiast tryb firmowy nadaje każdemu użytkownikowi osobne poświadczenia EAP z unikalnymi kluczami sesji. W grę wchodzą role suplikanta w kliencie, uwierzytelniającego w punkcie oraz serwera uwierzytelniania na portach UDP 1812 i 1813. Najbezpieczniejsza metoda EAP-TLS używa certyfikatów klienta, a tunelowane PEAP i EAP-TTLS chronią starsze hasła.

Tryb Enterprise jest standardem w sieciach korporacyjnych i akademickich, ponieważ umożliwia centralne zarządzanie dostępem, audytowanie i natychmiastowe odbieranie uprawnień poszczególnym użytkownikom. Serwer RADIUS (np. FreeRADIUS, Microsoft NPS) przechowuje bazę użytkowników i podejmuje decyzje o autoryzacji. Protokół EAP-TLS, oparty na wzajemnym uwierzytelnianiu certyfikatami X.509, jest uznawany za najbezpieczniejszą metodę uwierzytelniania w sieciach WLAN.

W kontekście warstw OSI: sam proces uwierzytelniania EAP zachodzi ponad warstwą łącza danych. Ramki EAP są transportowane przez protokół EAPOL (EAP over LAN) na warstwie 2, natomiast komunikacja między AP a serwerem RADIUS odbywa się przez protokół UDP (warstwa 4) na porcie 1812 (uwierzytelnianie) i 1813 (accounting).

58/58
Praktyczne aspekty zabezpieczania sieci WLAN
Cel slajdu: Slajd podaje praktyczne filary ochrony WLAN: MFP, OWE, segmentację VLAN oraz nadzór WIDS i NAC.
  • Management Frame Protection (MFP/802.11w): Chroni ramki zarządzające (Deauthentication, Disassociation) przed fałszowaniem. Obowiązkowe w WPA3.
  • Opportunistic Wireless Encryption (OWE): Mechanizm szyfrowania sieci otwartych (bez hasła) w WPA3, zapobiegający pasywnemu podsłuchowi.
  • Segmentacja sieci: Tworzenie osobnych VLAN-ów i SSID-ów dla różnych grup użytkowników (pracownicy, goście, IoT).
  • Monitoring i IDS/IPS: Systemy WIDS/WIPS wykrywają nieautoryzowane punkty dostępowe (Rogue AP) oraz próby ataków na sieć bezprzewodową.
  • Regularna aktualizacja: Firmware Access Pointów i kontrolerów powinien być regularnie aktualizowany w celu eliminacji odkrytych podatności.
Praktyka zabezpieczania WLAN (MFP/802.11w, OWE, VLAN, WIDS/WIPS, NAC): Ochrona ramek zarządzania MFP blokuje podrabiane rozłączenia i jest obowiązkowa w WPA3, natomiast szyfrowanie sieci otwartych OWE chroni przed biernym podsłuchem. Segmentacja na VLAN dla pracowników, gości i internetu rzeczy ogranicza skutki włamania, a systemy wykrywania WIDS tropią fałszywe punkty i ataki. Dopełiają to aktualizacje firmware i kontrola dostępu NAC sprawdzająca tożsamość oraz stan urządzenia.

Zabezpieczanie sieci WLAN to proces ciągły, wymagający podejścia wielowarstwowego. Samo włączenie WPA3 nie gwarantuje bezpieczeństwa – konieczna jest właściwa segmentacja, monitoring i polityka zarządzania dostępem. W środowiskach korporacyjnych kluczowe jest wdrożenie systemu NAC (Network Access Control), który weryfikuje nie tylko tożsamość użytkownika, ale również stan bezpieczeństwa urządzenia (np. aktualność systemu operacyjnego, obecność antywirusa).

Mechanizm OWE (Enhanced Open) w WPA3 rozwiązuje wieloletni problem sieci publicznych – nawet bez hasła, każde połączenie jest indywidualnie szyfrowane, co uniemożliwia pasywne podsłuchiwanie ruchu przez innych użytkowników tej samej sieci.